Translate

2023년 10월 4일 수요일

고위합성 자동화 도구의 동향(Automatic High-Level Code Deployment)

고위합성 자동화 도구의 동향

[역자주] 반도체 설계 분야의 최신 설계기법에 관한 동향보고서(survey)다. 영어공부도 편식하면 않되겠기에 이정도 글은 상식으로 읽어볼만 하다. 총 30여쪽인데 본문은 다소 전문적인 내용이 담겨 있으니 요약과 서론 부분을 발췌하여 읽기로 한다. 간간이 나오는 전문용어에는 나름 주석을 붙여 보겠다.

[원문출처] IEEE Access, Vol.8,2020, https://ieeexplore.ieee.org/abstract/document/9195872

---------------------------------------------------------------------------

Towards Automatic High-Level Code Deployment on Reconfigurable Platforms: A Survey of High-Level Synthesis Tools and Toolchains

  • 제목부터 길고 난해하다. 동원된 단어들은 기본수준 이지만 생략되고 축약되어서 이 논문이 어느 잡지에 실렸는지 모른다면 도데체 무슨 내용인지 감 잡기 어렵다. 구글의 번역의 도움을 받아보니 이렇게 나왔다.

"재구성 가능한 플랫폼의 자동 고급 코드 배포를 향하여: 고급 합성 도구 및 도구 체인에 대한 조사"

  • 번역된 내용은 나중에 따지기로 하고 몇가지 외국어들이 눈에 띈다.  '플랫폼', '코드', '체인'은 우리말에 동화된 외래어가 되어 버렸다는 뜻일까? 그렇다면 우리는 이 외래어를 적절하게 사용할 수 있어야 할 것이다. 이 논문이 전기전자공학기술자들의 전문지 IEEE Explore에 실렸다는 점을 감안하면,
    • 'platform'은 각종 논리회로의 요소들을 미리 배치해 놓은 FPGA(Field Programable Gate Array),
    • 'code'는 계산법(algoritjm)을 높은 추상화 수준의 컴퓨팅 언어로 기술한 원시구문(source code)을 뜻한다. 이렇게 옮겨 봤다.

"높은 추상화 수준에서 작성된 설계구문을 재구성 가능한 반도체 토대 위에 구현하는 자동화된 방법에 대하여: 고위 합성과 그와 동반하는 일련의 도구들의 동향보고"

MOSTAFA W. NUMAN[1], BRADEN J. PHILLIPS[2], (Member, IEEE), GAVIN S. PUDDY[1], (Associate Member, IEEE), AND KATRINA FALKNER[1]
Corresponding author(교신저자): Mostafa W. Numan (mostafa.numan@adelaide.edu.au)

[1] School of Computer Science, The University of Adelaide, Adelaide, SA 5005, Australia / 호주 아델레이드 대학교, 컴퓨터과학과
[2] School of Electrical and Electronic Engineering, The University of Adelaide, Adelaide, SA 5005, Australia / 아델레이드 대학교 전기전자 공학과

This work was supported by the Maritime Division of the Defence Science and Technology Group, Australia.

이 논문은 국방과학기술단 해양과의 지원을 받아 수행되었음.

---------------------------------------------------------------------

ABSTRACT

요약

Heterogeneous computing systems with tightly coupled processors and reconfigurable logic blocks provide great scope to improve software performance by executing each section of code on the processor or custom hardware accelerator that best matches its requirements and the system optimisation goals.

범용 연산기와 재구성 가능한 논리회로부가 밀접히 결합된 이종 연산기 체계는 구문을 범용 계산기와 전용 계산회로로 구성된 가속기에서 나눠 실행시키고 체계적으로 최적화함으로써 높은 실행 성능을 발휘한다.

  • heterogeneous computing system: 이종 연산기 체계
    • processors: 범용계산기 CPU
    • reconfigurable logic blocks: 전용계산기 FPGA
  • 'tightly coupled' 범용계산기와 재구성 가능 전용 계산기의 밀접한 결합을 강조하고 있다.
  • Reconfigurable 은 Programmable 과 같은 의미
  • 'improve software performance' 는 HLS의 목적

This article is motivated by the idea of a software tool that can automatically accomplish the task of deploying code, originally written for a conventional computer, to the processors and reconfigurable logic blocks in a heterogeneous system.

원래 전통적인 전자계산기에 수행되도록 작성된 구문을 범용 계산기와 재구성 가능한 논리계산기로 구성된 이종 계산기 체계에 자동으로 구현하는 소프트웨어 도구들이 등장하였기에 이 논문을 작성하게 됐다.

We undertake an extensive survey of high-level synthesis tools to determine how close we are to this vision, and to identify any capability gaps.

우리는 고위합성도구가 이 기대에 얼마나 가까워 졌는지 그리고 그 간격이 어느 정도인지 알기 위해 심도있게 조사해봤다.

  • high-level synthesis(HLS): 고위합성 (높은 추상화 수준)
  • gaps: 계산법을 기술하는 방법 사이에서 추상성(abstraction level)의 차이.
    • 범용 컴퓨팅 언어는 추상성 수준이 높다.
    • 전용 하드웨어는 RTL(Register-Transfer Level)로 추상성이 낮다.
  • RTL(Register-Transfer Level): 클럭(number of clocks)과 비트-폭(bit-width)의 상세

The survey is structured according to a new framework that clearly expresses the relationships between the many tools surveyed.

이 조사는 다양한 도구들을 살펴보고 그들 사이의 관계를 분명히 하는 시각에서 살펴봤다.

  • new framework: 도구의 우열이나 장단점을 찾기보다 각 도구마다 가진 특징을 알아보고 그 도구들 사이의 관계를 정리해봤다.

We find that none of the existing tools can deploy general high-level code without manual intervention.

우리는 이번 조사에서 손보지 않고도 고위 구문을 낮은 RTL의 하드웨어로 변환 할 수 있는 도구는 없음을 알았다.

  • 현재 성숙된 단계에 이른 HDL(Hardware Description Language)에도 합성 가능한 구문 형식이 있다(synthesizable subsets). 하물며 이보다 높은 추상화 수준의 C++는 어떠랴.

Logic synthesis from arbitrary high-level code remains an open problem with dynamic data structures, function pointers and recursion all presenting challenges.

매우 높은 추상화 수준의 구문으로부터 논리식 합성이 가지고 있는 과제로는 동적 자료처리, 주소변수 함수, 재귀호출 등은 여전히 해결되지 않고 있다.

  • dynamic data structures: 동적 자료구조. 메모리 할당(memory allocation), 링크 리스트(linked-list), 스택 포인터(stack pointer) 등.
  • function pointers: 함수의 주소를 포인터 변수에 대입하여 호출하는 기법
  • recursion: 함수 내에서 자신을 호출. 프랙탈(Fractals) 알고리즘

Other challenges include automating the tasks of code partitioning, optimisation and design space exploration.

그외 어려운 과제로는 자동화된 구문 분할, 최적화, 설계 구조 평가 등이 있다.

  • C++ 컴파일러의 다양한 기계어 코드 생성 옵션을 상기해 보자.
    • 코드 크기/실행속도 최적화
    • 인-라인 코드 인-라인
    • 호출 방식
    • 자료형 변환

-------------------------------------------------------------------------

요약만 보더라도 굉장히 많은 토론꺼리를 담고 있다. 분량이 다소 많긴 하지만 최신 반도체 설계 기법에 관심이 있다면 전체 논문을 읽어보길 권한다.

SECTION I.Introduction

For the last four decades, Moore's law and Dennard scaling have relentlessly delivered improvements in computing performance [1]. Since the early 2000s their impact has begun to wane and alternative ways to improve performance have begun to emerge.

Heterogeneous computing is a promising approach in which a group of processing nodes execute a workload in parallel. Given different kinds of nodes including multi-core CPUs, real-time processors, DSPs, GPUs, and accelerators on FPGAs or ASICs, the computing workload can be partitioned such that each part is executed on a processor that is well-matched to its requirements and the performance optimisation goals.

This article is concerned with the engineering task of writing software for a heterogeneous system and considers how close existing tools and technologies are to a fully automatic system in which high-level source code is partitioned and deployed to heterogeneous nodes with a minimum of human intervention. This is an ambitious scope so we constrain ourselves, in this article, to the task of deploying source code blocks onto custom FPGA logic.

It is possible, of course, to write software specifically for a particular heterogeneous system by manually partitioning tasks among the processors, and using the most appropriate programming language for each of the different processors. For example a Hardware Description Language (HDL) such as Verilog could be used for tasks executing on an FPGA, and CUDA for those on a GPU. An alternative, which has seen a great deal of research activity in recent years, is to use High-Level Synthesis (HLS) for generating hardware modules from code written in a High-Level Language (HLL) (such as C, C++ or Python).

There are benefits of using HLS instead of HDL so that the entire application is in a high-level language: simulation speed is generally faster; debugging is less difficult; it is easier to explore and evaluate design alternatives; and the high-level language may include features that cannot be easily expressed in a HDL [2].

Although current HLS tools do not always produce performance-optimised implementations, applications without stringent performance requirements can be more quickly and easily developed using HLS. HLS software developers do NOT necessarily need to be FPGA or HDL experts, and optimisation opportunities can be exposed to the designer that cannot be easily explored via HDL approaches. In some cases, a project that would not have been practical in HDL, given its complexity, limited time frame and small development team, can be feasible in HLS at a low performance cost compared to an HDL-based approach [3]–​[5].

An HLS-based design for a heterogeneous system could be started from scratch, or use pre-existing code originally written for a conventional CPU. Either way, to effectively use current HLS technology, system developers require considerable knowledge and experience in the application domain, computer programming, and HLS design flow.

Deploying pre-existing code written for a conventional CPU onto a heterogeneous system with the aim of improving performance or efficiency is even more difficult. The code needs to be substantially restructured to be synthesisable, and to produce optimised hardware. This needs to be done for all the code: not just the application source code but also any library functions it uses. To date Automatic Code Deployment (ACD) tools capable of performing this challenging task without human intervention have been the subject of limited research (e.g. [6], [7]) but a considerable amount of work has been done on automating some of the more challenging, tedious and time-consuming steps in this process (e.g. [8]–​[11]).

This article surveys recent toolchains and workflows for high-level synthesis to FPGA with a focus on technologies that might eventually be used for automatic code deployment. Section I introduces HLS and the motivation for heterogeneous computing based on HLS. Section II categorises different contemporary approaches to deploy compute-intensive code segments to FPGA hardware accelerators. The categories introduced in Section II are used to organise a thorough survey, in Sections III and IV, of approaches that take a candidate function expressed in a HLL and produce low-level HDL suitable for FPGA deployment. The arguments in these sections focus on contemporary HLS tools currently used in academia or industry; legacy tools are included in summary tables for completeness. Specification of a hypothetical tool for ACD to FPGA, as well as a brief summary of progress reported in the literature towards making HLS-based FPGA code deployment less dependent on human judgement and proficiency, are provided in Section V.

SECTION II.High-Level Code Deployment Approaches
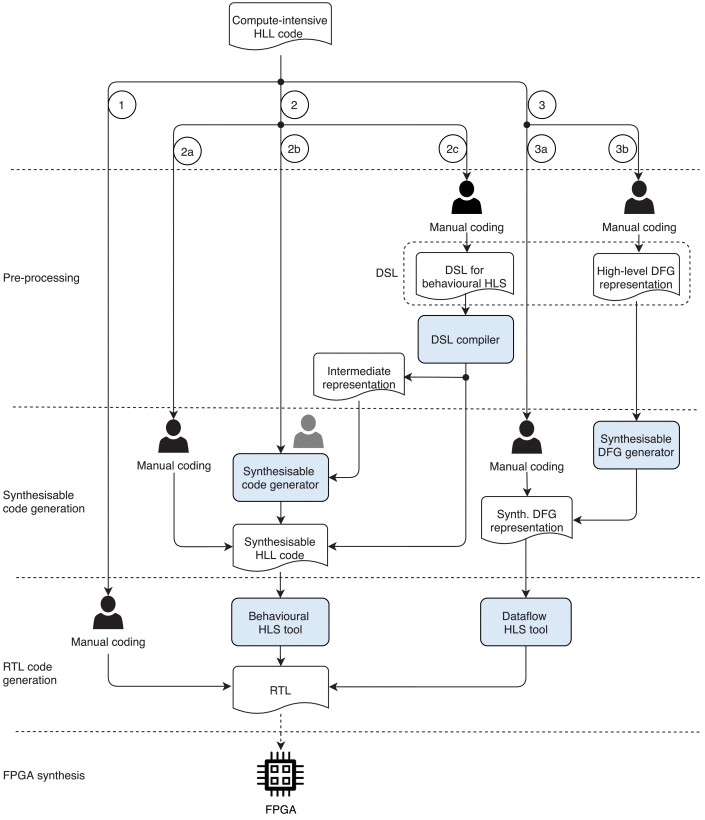

FIGURE 1. Design flows for high-level code deployment.

FIGURE 1. Design flows for high-level code deployment.


SECTION III.Behavioural Approach for FPGA Synthesis
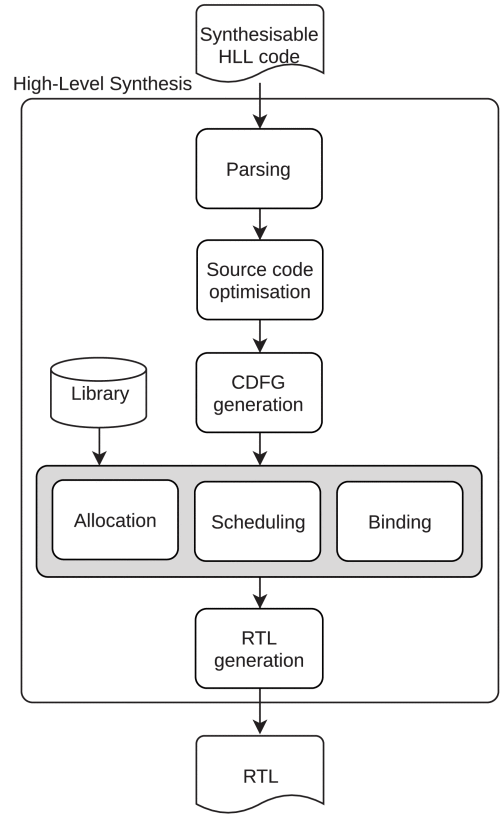

FIGURE 2. A generic HLS design flow.
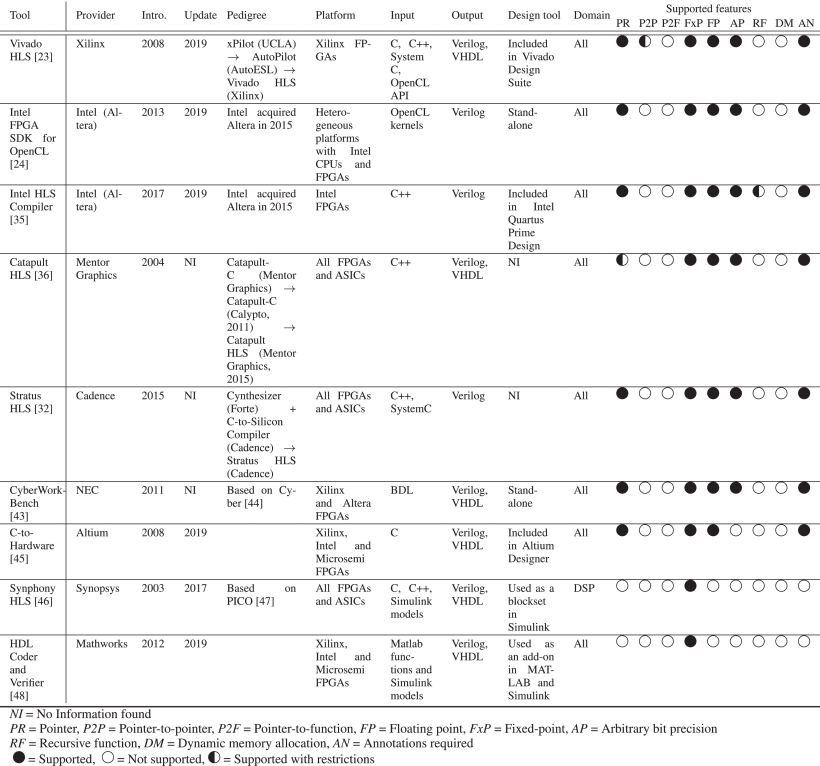
FIGURE 2. A generic HLS design flow.


TABLE 1 Currently Available Commercial HLS Tools
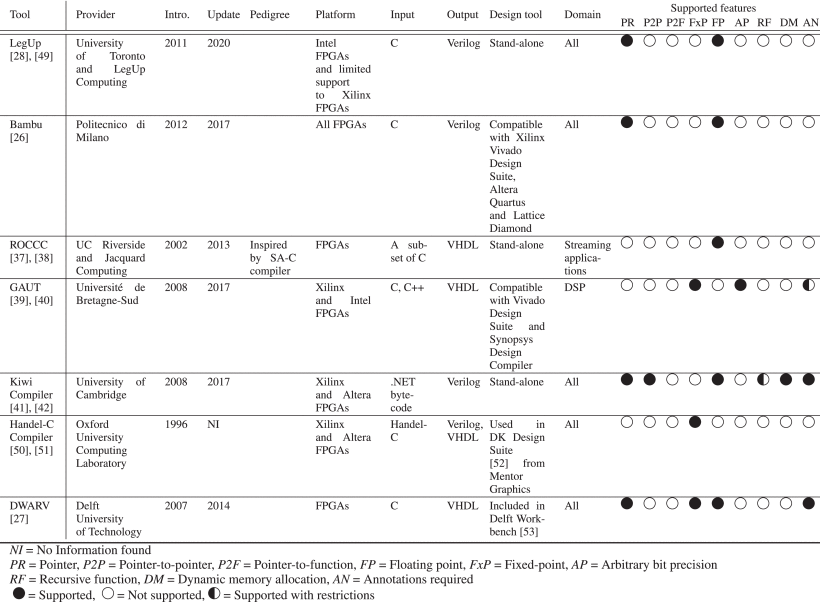
TABLE 2 Currently Available Academic HLS Tools

----------------------------------------------------------------------

원 논문에 각 HLS 도구들의 작동 방식을 간략히 설명하고 있으니 찾아보자. 어떤 기법들이 동원되고 있는지 눈여겨볼 만 하다.

SECTION VI.Conclusion

The motivation for this article was a vision of a software tool that could automatically deploy sections of code, originally written for a conventional CPU, to FPGA accelerators to achieve an implementation advantage, whether that be latency, throughput, energy or some other optimisation goal. How close are existing tools to this delivering this vision, and where are the capability gaps?

To survey and evaluate existing tools we provided a classification of design flows in FIGURE 1. This classification has neatly expressed the relationships between many different hardware synthesis tools surveyed under three broad approaches: manual re-coding, behavioural synthesis, and dataflow synthesis, as well as variations of these.

Sections III and IV surveyed many commercial and research tools for code deployment, organised according to the framework in FIGURE 1. Wherever possible we have identified the pedigree of these tools and their relationship to other tools in the survey. For the more widely used or surveyed tools we have provided an overview of salient features and capabilities.

None of the existing tools are able to fulfil the vision of fully automatic deployment of general C/C++ code to a heterogeneous system of FPGAs and CPUs. Capability gaps include the generation of synthesisable HLS code from HLL code that uses pointers to pointers or functions, recursive functions, or dynamic memory allocations. Other challenges include efficient partitioning of the code, optimisation of generated hardware, and design space exploration. All of these are the subject of active research efforts as surveyed in Section V-B.

This work has also identified a trend that is somewhat orthogonal to the idea of automatic code deployment. There is currently significant work in approaches to express the application in a high level language that is more amenable for execution on diverse platforms. Examples include the growing proliferation of domain-specific languages or dataflow representations.


2023년 9월 13일 수요일

오늘의 반도체 설계, 20년 전과 다를까?

오늘의 반도체 설계, 20년 전과 다를까?

각종 매체에 '반도체'라는 말이 등장 할 때 따라붙는 접미어를 보면 크게 '물질'과 '공정' 그리고 '설계'일 겁니다. '공정'은 '몇몇 나노 공정' 이라며, 숫자가 작을 수록 최신 공정이라며 뉴스꺼리로 주목을 많이 받습니다. 그리고 반도체 '물질' 역시 큰 주목을 받는데, 탄소 반도체, 초전도 반도체 등 입니다. 역시 신물질이라며 주목을 받죠. 그런데 '설계'에 관한 기사는 드믈고 그나마 '인력양성' 또는 '시스템 반도체' 라는 기사에 잠깐 언급되는 정도 입니다.

'공정'을 제조기술이라고 한다면 '설계'는 기능의 구현기술 이라고 하겠습니다. 말하자면 '설계'는 제조와 기능 사이에 연결고리가 되는 도면을 그리는 일입니다. 해야할 일이 많아지면 그 기능들을 수행할 전자회로는 복잡해 집니다. 그저 복잡하다고 표현 하는 정도가 아니라 너무나 복잡해 집니다. 요즘 PC에 사용되는 중앙연산장치 반도체(CPU) 내부의 트랜지스터 갯수는 수십억개 라고 합니다[참조]. 굳이 말로 표현하자면 이 반도체를 제조하려면 수십억(!)개의 부품으로 구성된 도면을 그려줘야 한다는 뜻입니다. 사람이 할일이 아니죠. 할 수도 없구요. 그래서 부품들을 모두 규격화 해놓고 수많은 부품을 규칙적으로 배치하고 배선해 주는 반도체 설계 자동화 도구라는 소프트웨어를 동원 합니다.

현대적인 반도체 설계는 할 일을 문서로 작성해 주면 자동화 소프트웨어가 이를 전자회로의 도면으로 변환해 줍니다. 이는 프로그래밍 언어로 할일을 작성하고 컴파일러로 실행 파일을 만드는 소프트웨어 개발과 다를바 없습니다. 요즘은 반도체 설계도 소프트웨어 개발 처럼 컴퓨터 언어로 할일을 작성해 주면 컴파일러(합성기와 배치배선기)가 알아서 도면을 작성해 줍니다. 그렇지 않고서야 어떻게 수십억개의 트랜지스터가 들어간 반도체 제조 도면을 만들겠습니까!

지지난 달 부터 대학에 나가 반도체 설계를 가르칠 기회가 생겨서 강의록을 만들려고 자료를 찾다가 20년 전의 반도체 설계 강좌 기사를 발견하여 읽어 봤습니다. 연재글 제목도 아주 매력적 입니다.

"마이크로프로세서 설계 무작정 따라하기" [링크]

컴퓨터 활용서나 코딩 교육 입문서에 '무작정 따라하기'가 붙은 제목은 봤어도 반도체 설계에 이런 제목이라니 매우 과감했다는 생각이 들더군요. 아마 그 시절의 시각에서 보면 어쩌면 황당했을 지도 모릅니다. 물론 적어도 전자공학을 전공하는 대학생을 염두에 둔 글이긴 하지만 따라하기에 필요한 도구(소프트웨어)들이 너무나 고가 인데다 쉽게 접근하기 어려웠기 때문 입니다. 물론 20년 전의 소프트웨어 개발 도구들(컴파일러)의 가격도 만만치 않았지만 마음만 먹으면 그럭저럭(?) 사용하는데 크게 무리는 없었지만 반도체 설계 도구들을 구하기는 매우 어려웠습니다. 도구의 희귀성으로 인해 오늘의 반도체 설계 인력 부족이라는 문제를 낳게 된 요인의 하나였을 것이라는 생각이 듭니다.

오늘 우리의 반도체 설계 여건은 20년 전에 비할 수 없이 달라졌습니다. 감히 엄두도 못내던 설계도구들이 제작사들의 관대함 덕분에 무료 라이센스가 발행되고 있습니다. 오픈 소스 소프트웨어는 소프트웨어 개발 도구 뿐만 아니라 반도체 설계도구도 예외는 아닙니다. 시뮬레이터, 컴파일러(합성기), 배치배선기, 레이아웃 편집기들은 교육용 뿐만 아니라 중소규모 반도체 설계용으로 손색이 없습니다. 이제 말그대로 '무작정 따라하기'에 장애가 없어졌습니다. 이에 덧붙여 국내 기관(ETRI 등), 대학 연구소에 설치된 실험용 공정에서 교육 목적으로 반도체 제작을 지원한다는 소식이 있으니 더욱 반갑습니다. 외국의 경우 이미 FPGA 를 사용한 반도체 설계가 취미로 자리하여 재미있는 '프로젝트' 들이 공개되는 것을 봅니다. 반도체 설계를 '무작정' 따라할 만큼 충분한 여건이 되었습니다.

한가지 덧붙이자면,

반도체와 관련된 뉴스의 화면에 방진복을 입은 작업자의 모습을 그만 봤으면 좋겠습니다. 팬데믹 사태를 격으며 힘들던 시절의 모습을 떠올리게 합니다. 청정실이라고는 하지만 마치 감옥에라도 갇혀있는 듣한 모습은 매력적이지도 않고 숨이 막힙니다. 반도체 업계는 마치 '공정'만 있는 듯이 보입니다. 허옇고 누런 색과 단조로운 기계적인 모습 대신 역동적인 화면(그래봐야 코드 리스팅이지만)과 설계자들의 자유분방한 화면을 보여주면 좋겠습니다. 적어도 시뮬레이션 화면의 파형 정도는 보여줘도 되는것 아닌가요? 소프트웨어 산업을 소개할 때처럼 남녀 설계자들의 매력적인 모습을 보여 줬으면 좋겠습니다.

---------------------------------------------------------------

두번째 덧붙이자면,

20년전이나 지금이나 '반도체 설계'는 규모만 커졌지 기조는 바뀐 것이 없습니다. 여기서 말하는 '설계'는 하드웨어용 언어로 작성된 할일(알고리즘)을 디지털 회로(트랜지스터 조합)로 변환해주는 과정을 말합니다. 오늘날 이런류의 '설계자동화'는 관심을 얻지 못합니다. 당연하게 여기게 된 것입니다. 마치 소프트웨어 언어의 컴파일러 제작이 고급 기술이 아닌 평범해 진것과 같은 이유 입니다. '하드웨어 문서에서 실리콘으로' 이어주던 자동화 기술이 정점에 이른 지금은 좀더 높은 수준의 자동화에 관심을 갖게 되었습니다. '하드웨어 문서'에서 '하드웨어' 라는 말을 빼려는 것입니다. 하드웨어를 목적으로 만든 문서를 전자회로로 바꾸는 설계 자동화는 평범해진 것입니다.

인간의 언어와 가깝도록 발전한 (소프트웨어) 프로그래밍 언어는 알고리즘을 수월하게 표현할 수 있습니다. 굉장히 많은 사람들이 이 언어를 이용해 전자회로에게 일을 시키고 있죠. 프로그래밍 언어로 작성된 알고리즘을 전자회로에서 작동시키려면 컴파일러라는 도구를 사용합니다. 이 도구는 범용 계산기(CPU, GPU 같은)에서 작동될 수 있도록 일반 문서를 기계용 문서로 바꿔 주는 역활을 합니다. 문제는 이 범용 계산기의 성능(처리속도)이 인공지능이나 기계학습처럼 대규모 데이터를 다뤄야 하는 응용에 만족스럽지 않다는 것입니다. 동시다발로 생성되는 데이터를 받아들이려면 그 숫자만큼의 컴퓨터가 필요한데 경제적으로나 기술적으로나 부담이 아닐 수 없습니다. 그래서 계산기에서 '범용'을 빼려고 합니다.

신경망이라고 하는 인간의 사고체계를 모형화하고 전자회로로 구현하고 싶어진 것입니다. 인간두뇌의 신경세포의 수 만큼은 아니더라도 수천(또는 수만개)개의 CPU가 서로 연결된 계산기를 만들고 싶어진 것입니다. 이런 계산구조의 유용성은 이미 증명되었습니다. 하지만 범용 CPU가 하나 달린 컴퓨터 여러개를 연결하려면 여간 수고로운게 아닙니다. 그래서 수천개의 CPU를 가진 컴퓨터를 만들려고 합니다. 다행이라면 신경망을 구성하는 계산기(신경세포)가 이것저것 다하는 범용 계산장치(CPU)보다 아주 단순하다는 것이죠. 손톱만한 반도체 위에 단순 계산장치 수천개를 서로 연결해 놓고자 합니다.

응용에 따라 알고리즘은 달라 집니다. 이 알고리즘은 프로그래밍 언어로 쉽게 작성 할 수 있습니다. 그래서 프로그래밍 언어로 작성된 알고리즘을 반도체 회로로 바꿔주는 자동화 도구가 등장 했는데 이를 고위합성(HLS, High-Level Synthesis)이라고 합니다.

어쨌든 계산을 수행하는 전자회로는 '하드웨어' 입니다. 이 하드웨어는 한번 만들어지면 고치지 못합니다. 그래서 컴퓨터는 다재다능하도록 만들어 놓은 범용 CPU를 두고 프로그램을 바꿔가며 해당기능을 수행 합니다. 이를 '소프트웨어'라고 합니다.

FPGA 라는 반도체 부품(IC)가 있습니다. 이 반도체는 논리적인 수준에서 구조를 바꿀 수 있습니다. 전자회로의 말단에 해당하는 트랜지스터는 고정되어 있지만 그보다 윗단계에서 산술논리 계산을 수행하는 계산기 구조를 마음대로 재구성 할 수 있습니다. 말하자면 특정 알고리즘에 맞춰 그에 최적화된 CPU로 변신 시킬 수 있는 반도체 부품이 바로 FPGA 라는 것입니다. 프로그램될 수 있는 하드웨어 입니다. 하드웨어가 소프트 해졌다는 뜻입니다.

HLS와 FPGA를 결합하여 프로그래밍 언어로 작성된 인공지능 알고리즘을 소프트해진 하드웨어에서 작동 시키고자 하는 연구가 한창이고 곧 실현될 조짐을 보이고 있습니다.

20년전에 반도체 설계라 하면 '하드웨어용 문서'를 작성하는 행위 였다면 오늘의 반도체 설계는 '하드웨어용'이라는 제약을 떼내고 '일반 문서'를 작성하는 행위로 바뀌었다는 것이 가장 큰 차이라 하겠습니다.

재작년(2021)에 Xilinx의 HLS 툴이 신통하길래 봐뒀는데 이렇게 유용할 줄은 생각도 못했습니다.

--------------------------------------

[참고]
[1] AI_accelerator, https://en.wikipedia.org/wiki/AI_accelerator
[2] Xilinx Research & Open Source Projects, https://www.youtube.com/@xilinxresearchopensourcepr321
[3] HLS Programming with FPGAs, https://www.youtube.com/@youngkyuchoi4260
[4] FINN tutorial at FPGA'21, https://xilinx.github.io/finn/2021/01/27/finn-tutorial-fpga21.html
[5] 고위합성 튜토리얼 개요 (Tutorial Description), https://hls-goodkook.blogspot.com/2021/08/1-tutorial-description.html

2023년 8월 10일 목요일

Open Source HLS

3D raytraced game with open source C to FPGA toolchain
A look at CFlexHDL and PipelineC


Graphics demos implemented using PipelineC.

PipelineC
A C-like(1) hardware description language (HDL)(2) adding high level synthesis(HLS)-like automatic pipelining(3) as a language construct/compiler feature.

CflexHDL
Design digital circuits in C. Simulate really fast with a regular compiler!

LiteX
The LiteX framework provides a convenient and efficient infrastructure to create FPGA Cores/SoCs, to explore various digital design architectures and create full FPGA based systems.

LLVM
This repository contains the source code for LLVM, a toolkit for the construction of highly optimized compilers, optimizers, and run-time environments.

MyHDL
From Python to Silicon

NNgen
A Fully-Customizable Hardware Synthesis Compiler for Deep Neural Network

Veriloggen
A Mixed-Paradigm Hardware Construction Framework


2021년 12월 17일 금요일

HLS/SystemC Project: Canny edge detector (Legup HLS)

 HLS/SystemC Project: Canny edge detector (Legup HLS)


Download source[link]


HLS/SystemC Project: Canny edge detector (Xilinx HLS)

 HLS/SystemC Project: Canny edge detector (Xilinx HLS)


Download source[link]


HLS/SystemC Project: Canny Edge Detector, Part 1. C-Design

HLS/SystemC Project: Canny Edge Detector, Part 1. C-Design

0. 개요

고위합성(HLS) 도구들이 실제 개발 프로젝트에 활용될 만큼 상당히 성숙되었다. 숙련된 설계자에 의해 수작업된 RTL 코드 대비 80%에 이르럿다고 주장한다[인텔]. 평균 경력자에 의해 개발이 수행될 경우 소요될 개발 기간을 따진다면 충분히 수용할 수 있는 수준이라고 할 만 하다. 저전력 대량생산용의 ASIC 이라면 다소 무리가 있겠으나 계산 지향적 시스템에 채택된 재구성이 가능한 FPGA에 대해  고속 하드 웨어 개발은 HLS로도 충분할 것이다. 특히 낮은 클럭으로도 높은 계산 성능이 요구되는 분야라면 더욱 그렇다. [원격측정, 우주항공, 의료, 군사]

HLS 기반의 설계 방법론의 가장 큰 장점은 알고리즘에서 디지털 회로까지 추상성 수준의 범위가 매우 넓음에도 설계도구의 핵심인 기술(설계)언어의 끊김을 없앴다는 점이다. C/C++ 는 알고리즘 개발 언어로서 압도적 위치에 있다. HDL은 하드웨어 설계 언어로서 확고하게 자리잡았다. C/C++에서 RTL/HDL로 변환해 주는 HLS는 이 둘사이의 깊은 골에 놓인 가교가 되었다. 따라서 HLS 도구가 받아들이는 C 코드는 표준 C/C++에서 벗어나지 않아야 한다. 또 다른 변종 혹은 유사 C/C++가 되지 말아야 한다.

하지만 아쉽게도 HLS 개발사 마다  자체적으로 C++ 크래스 라이브러리를 제공 하거나 심지어 변형된 C 문법을 제시하기 까지 한다. 이들이 제시하는 새로운 키워드 들은 대부분  지시자(pragma directive)에 가깝다. 또는 컴퓨터에 장착된 가속기 하드웨어(GPU, FPGA 애드온 보드)에 접근하기 위한 API를 크래스를 제공하는 경우다[인텔의 oneAPI/DPC++]. 이들은 합성용 이라기 보다 소프트웨어와 하드웨어의 실행 방식을 극복하려는 노력의 일환일 뿐이다.

C/C++와 RTL/HDL의 사이에 자료의 표현과 구문실행 방식에 큰 차이가 존재한다.  하드웨어를 목표로 작성된 C코드를 검증하려면 병렬 실행을 모의해야 한다. C 코드를 하드웨어처럼 실행시키기 위해 제공되는 라이브러리들은 대개 스트리밍, 메모리, FIFO 같은 입출력 인터페이스를 모의하기 위한 것들로 HLS의 목적과 무관하다. 심지어 C/C++ 조차 버거워 하는 현실을 감안해 볼 때 이를 위해 새로운 컴퓨팅 언어(DPC++ 같은)를 제시하는 것이 합당한지 의문이 든다.

그외 테스트 벤치 자동생성 같은 도구들을 제공하겠다며 괸시리 C 설계 코드를 기괴하게 만들기도 한다. 응용에 따라 매우 다양한 모습을 띄게되는 테스트 벤치는 일반화 할 수 없다. 그럼에도 HLS 툴 벤더들이 이미지 처리나 신호처리 라이브러리를 제공하려 드는 경우를 본다. 자사 툴 고객들의 검증 프로젝트 마다 대응하겠다는 각오가 아니면 그만두는 편이 좋겠다.

하드웨어 실행 방식을 모의하길 원한다면 이미 표준으로 제정된 SystemC라는 크래스 라이브러리를 활용하자. 저마다 검증환경의 구축은 사용자들에게 맞기고 함수의 블럭 입출력 핸드쉐이크, FIFO 및 메모리 인터페이스, 시스템 버스, IP 패키지 등과 같은 HLS 표준화와 표준 C 코드와 합성 지시자를 규격화 하는데 집중해 주길 바란다. 합성가능한 코딩 스타일에 관한 표준이 마련되자 HDL 기반의 설계 방법론이 확고하게 자리잡을 수 있었다.

(LLVM 같은 매우 정교한 C/C++ 언어 프론트 엔드)

이번 고위합성(HLS)과 SystemC 테스트벤치 프로젝트는 케니 윤곽선 추출기다. SystemC의 FIFO 채널을 이용해 시스템 수준 테스트 벤치를 구축해 놓음으로써 다단 알고리즘으로 구성된 처리기를 구성하는 각 알고리즘을 개별적으로 그리고 동시에 개발이 진행되고 검증될 수 있음을 보여줄 것이다. 표준 C/C++로 기술된 알고리즘을 SystemC의 FIFO 채널로 연결한 테스트 벤치와 함께 실행형 사양으로 제공될 것이다. 각 알고리즘은 최적의 HLS용으로 수정되고 검증되어야 한다. 모듈간 인터페이스는 FIFO로 규정하고 HLS의 입력으로 표준 C/C++ 로 기술된 코드만을 허용한다.


<그림>

1. 케니 외곽선 검출기

캐니 외곽선 검출기(Canny edge detector)는 영상인식과 같은 응용을 목적으로 외곽선 추출에 널리 활용되는 영상처리 기법으로 다단 알고리즘(multi-stage)으로 구성되었다. [Wiki]

다단 알고리즘(multi stage algorithm):

멀티미디어 처리기(압축 인코더, 특징 추출기등)들은 고품질과 고효율을 얻기 위해 다단 알고리즘으로 구성된다. 멀티미디어 압축기의 표준이라 할 수 있는 MPEG 처리기의 경우 기본적으로 DCT(Discrete Cosine Transform), 위신호 제거(Anti-aliasing), 양자화기(Quantizer), 허프만 코더(Huffman coder)들을 포함한다. 손실을 최소화 하면서도 최고의 압축효율을 얻기 위함이다.

캐니 외곽선 검출기는 영상인식을 위한 특징 추출의 전단계에서 더 나은 인식성능을 얻기 위한 영상처리기로 가우시언 필터(Gaussian filter), 소벨 필터(Sobel filter), 최대치 억제기(Non-Maximum suppressor)  그리고 이력 제거 필터(Hysteresis filter) 등 4가지 알고리즘으로 구성되었다. [주: 다수의 알고리즘(algorithm)을 연속적으로 적용하였으므로 처리기(operator 또는 processor)라 한다. 예를 들어 'MP3 알고리즘'은 적절한 명칭이 아니다. 'MP3 압축기'라고 해야 한다.

<그림>

케니 외곽선 검출기를 구성하는 각 알고리즘의 하드웨어는 고위합성기(HLS)로 합성하여 얻는다. 고위합성으로 얻어진 하드웨어 모듈은 SystemC 테스트 벤치에서 검증될 것이다. 검증은 원시 C 코드와 HLS를 목표로 변형된 C 코드 그리고 고위합성으로 얻어진 RTL/HDL 코드를 동일한 SystemC 테스트 벤치 상에서 출력을 비교한다. 각 알고리즘은 개별적으로 합성되고 검증과정을 거칠 것이며 최종 검증된 각 하위 모듈들은 모두 통합하여 최종 검증을 수행한다.

<그림>

검출기를 구성하는 하위 알고리즘을 기술한 C 코드들을 한데 모아 합성할 수도 있을 것이다. 하지만 성격이 다른 여러 모듈들이 합성이 가능하도록 일거에 준비되기 어렵고 검증과정에서 발생한 오류에 대해 어느 모듈의 문제인지 특정할 수 없게 된다. 하위 모듈로 분리하여 동시 개발을 진행하고 검증된 모듈을 모아 전체를 완성하는 이른바 분할정복(divide and conqure)이 유리하다.

2. 인터페이스(Interface)

함수를 호출하면서 인수를 전달하고  되돌림을 받아내는 일련의 절차를 함수 호출 규약(calling convention)이라 한다. C 언어를 포함한 고수준 언어는 함수 호출규약을 표준 문서화(LRM)되어 있다. 따라서 높은 추상화 수준 언어를 사용한 경우 굳이 인터페이스와 재사용에 대한 고려를 하지 않고 알고리즘 자체에 집중할 수 있다.

하드웨어 모듈 사이의 데이터 전송 규약을 인터페이스(interface)라 한다. C에 비해 추상화 수준은 매우 낮은 RTL/HDL에 인터페이스 규약의 표준은 없다. 뿐만 아니라 함수 호출과 되돌림에 해당하는 모듈의 개시와 종료에 대한 규약도 없다. 개별 설계 조직 마다 내부 규약을 갖추고 있기 마련이다. 컴퓨터의 주변 장치라면 시스템 버스 규정을 따르면 될테니 그나마 명확 하겠으나 모듈간 인터페이스는 매우 신중히 결정되어야 한다. C에서 RTL/HDL로 합성하는 HLS 도구들은 나름대로 인터페이스 규약을 갖추고 있다. 함수의 시작과 종료를 다루는 모듈 핸드쉐이크 제어와 입출력 전달 방식을 규정한다. 모듈 핸드쉐이크는 대기 신호에 대하여 시작 신호를 주는 것으로 모듈 동작을 개시하고 종료 신호로 동작이 완료 됐음을 알게 된다. 단일인수(scalar)인 경우 인수의 전달과 되돌림 값을 받는 과정은 핸드 쉐이크 절차에 포함 된다.

만일 인수가 배열(또는 벡터, vector) 라면 인터페이스는 크게 두 가지 방식을 취한다. 첫 번째 방식은 메모리 인터 페이스다.


두 번째 방식으로 선입선출(FIFO) 채널이다.


메모리 입출력 인터페이스는 주소와 읽기/쓰기 가 메모리 접근을 위해 반드시 주소지정 절차가 선행되어 클럭 소모가 있다. 이에 덧붙여 RAM 또는 ROM 메모리는 반응속도가 느리다. 따라서 통신 채널로는 FIFO를 선호한다. 이에 덧붙여 FIFO의 경우 내부 저장 공간을 자체적으로 운용하므로 입출력의 동시 접근을 허용한다. 다단 알고리즘 구조를 갖는 처리기의 경우 매우 유리하다. FIFO를 단순 저장 메모리 장치라 하지 않고 채널(channel)이라고 부른다.

인터페이스에 따라 설계가 완전히 달리진다. 분할된 하위 모듈들 사이의 인터페이스 규약을 미리 확정해두지 않으면 쓸모없는 설계가 될 것이다. 모듈이 적용될 시스템의 규정이 명확히 명시 되어야 한다. 

3. HLS 목적의 C-모델 수정

알고리즘을 C언어로 기술한 것을 소프트웨어 모델이라고 하자. 알고리즘을 명확하고 적절하게 기술한다. 인수의 입출력은 재사용성의 관점에서 취급 하드웨어로 변활할 목적이라면 관점이 달라진다.

하드웨어를 목표로 C 모델을 변경할 때 기준:

인터페이스

자원활용

병렬성

변경후 표준 C 일것(이식성, 재사용성이 크게 훼손됨)

메모리 인터페이스의 경우. 배열이 일회성인가 또는 외부의 배열 저장소 포인터인가. 소프드웨에의 내부 임시저장소는 일회성으로 함수가 되돌려지는 순간 소멸. 대규모 저장소를 함수 내부에 두어도 동적 메모리 관리 기법을 쓴다면 부담이 없으나 하드웨어는 컴퓨팅 자원을 회수불가, 배열인수의 색인은 주소. 랜덤 주소와 순차 주소. FIFO 인터 페이스를 목표하는 경우 순차 주소되어야 한다.

SystemC 테스트 환경 구축후 소프트웨어 C모델과 하드웨어 C 모델의 검증

FIFO 채널. C++ 모델의 입출력 병렬처리 시뮬레이션

C++ 모델에 인터페이스 껍질 씌우기: 세가지

- 소프트웨어 모델

- 하드웨어 모델

- 출력비교 모델


세 가지 껍질 모두 동일한 인터페이스를 사용하여 재사용성을 높인다.

<그림>

4. 모델링 및 시뮬레이션 도구들

무료가 아니다. 상용 도구들이나 비용을 지불하지 않고 사용이 허가 되었다. FPGA 벤더의 자사 도구들 이거나 라이센스를 사다가 무료 제공한다. 자사 FPGA 제품의 시장 확보 방안으로 일부 기능을 특화하거나 일부 제한을 걸어두었다. 하지만 고맙게도 최근 배포되는 도구들은 제한이 거의 없어졌다. HLS 가 아직 널리 보급되지도 못한 탓에 이를 진흥하기 위한 방책이 아닐까 싶다. 물론 GNU 같은 공유 개발 개념이 자리잡은 탓도 컷을 것이다.

- C++ compiler: Visual Studio 2019 community version

- Data visualization: GNUPlot 5.4, GTKWave

- Testbench: SystemC 2.3.3

- HLS Tool: Xilinx' Vitis HLS 2021.1 and Microchip's SmartHLS (Legup)

- RTL simulator: QuestSim (Intel FPGA starter version, gcc and sccom)

5. 예제 소스 코드 다운로드 [link]

소스코드는 링크에서 내려받을 수 있다. C 모델과 SystemC로 작성한 테스트 벤치와 마이크로소프트 비쥬얼 스튜디오 2019 프로젝트, 퀘스타심 DO 스크립트들이 모두 포함 되었다.

도구 설치

- 비쥬얼 스튜디오 2019 C++ 와 피이썬 도구들을 함께 설치하자

- GNU Plot 은 설치후 bin 폴더를 PATH 에 추가해 두자

- HDL 시뮬레이터: 인텔 FPGA 스타터 버젼

- Xilinx VitisHLS & Microchip SmartHLS


폴더 구조

<그림>

실행


2021년 11월 13일 토요일

Microsemi (Actel FPGA)의 HLS 툴

Microsemi (Actel FPGA)의 HLS 툴

Microsemi 가 LegUp Computing 을 합병하였다. LegUp의 HLS 툴을 SmartHLS로 출시하였다. Microsemi는 FPGA 툴 LiberoSoC와 SmartHLS 그리고 Synplify Pro, Identify와 ModelSim(Questa의 이전 버젼. sccom 은 빠짐)을 1년 무료 라이센스를 제공하고 있다.

https://www.microchip.com/en-us/products/fpgas-and-plds/fpga-design-resources/smarthls-compiler#

그리고, 2020년 현재 HLS 도구들 현황 조사서 

Towards Automatic High-Level Code Deployment on Reconfigurable Platforms: A Survey of High-Level Synthesis Tools and Toolchains


2021년 11월 9일 화요일

HLS 온-라인 튜토리얼 (Siemend EDA & Intel FPGA)

HLS 온-라인 튜토리얼 (Siemend EDA & Intel FPGA)


1. Siemens EDA/Mentor Catapult HLS on-demand training

https://eda.learn.sw.siemens.com/training/courses/catapult-high-level-synthesis-library

Siemens/Mentor 의 Catapult HLS를 가상 컴퓨터를 통해 실습해 볼 수 있습니다.


2. Intel FPGA: Introduction to High-Level Synthesis

https://www.intel.com/content/www/us/en/programmable/support/training/course/ohls1.html

Intel FPGA의 Quartus Tool은 무료버젼으로 사용할 수 있음


* 위의 두 튜토리얼에 사용된 예제들이 Xilinx의 것에 비해 체계가 없고 너무 수준이 낮긴 한데 현재 각 벤더 들에서 어떻게 접근하고 있는지 비교해 볼 수 있음.

그리고, HLS 도구들 현황 조사서

Towards Automatic High-Level Code Deployment on Reconfigurable Platforms: A Survey of High-Level Synthesis Tools and Toolchains


64비트 모델심, Questa가 공짜라니!

64비트 모델심, Questa가 공짜라니!

줄수 제한도 없고 VHDL, Verilog, SystemVerilog, SystemC 모두 가능한 언어공통. 게다가 각종 프로시져 언어 인터페이스(PLI/VPI, FLI, VHPI, DPI 등등)를 위해 GCC-7.4 까지 포함 되었다. 일년단위로 갱신가능한 영구 라이센스라고 한다.

Questa Intel FPGA Starter Edition 2021.3 (No Line Limit & Mixed-Language Support)

https://www.intel.com/content/www/us/en/software/programmable/quartus-prime/questa-edition.html

Questa*-Intel® FPGA Starter Edition Software

- No line limitations

- 40% performance (on average) of Questa*-Intel® FPGA Edition Software

- Log into Self Service Licensing Center to get free one-year, perpetual license

- Mixed language support – Verilog/SystemVerilog, VHDL and SystemC


Thanks Intel & Siemens EDA !


2021년 10월 25일 월요일

고위합성 튜토리얼(High-Level Synthesis Tutorial)

고위합성 튜토리얼(High-Level Synthesis Tutorial)

High-Level Synthesis(HLS)을 일본에서 '고위합성'이라고 했던데 의미가 와닿게 옮겼다는 생각이다. [High Level Synthesis Blue Book 일본어판] 높은 추상화 수준으로 기술된 설계를 논리회로 하드웨어로 합성 해주는 기법 이다. 영어로는 C-Based design methodology, transforming C, C++, and SystemC code into Register Transfer Level (RTL) code for synthesis. 지난 시절 한때는 모질게 메달렸던 분야 였지만 떠난지 십년은 된 듯하다. 지금와서 다시 꺼내 보는 이유는 다 잊어 버리기 전에 정리해 두고 싶었기 때문이다. 변변한 HLS 툴 도 없어서(사실은 어마어마한 가격을 지불할 돈이 없었다.) 상상으로 공부하던 시절에 비하면 이 얼마나 감격인가 싶어서 20년전의 한을 풀어보고자 한다. 이 글을 쓰는 시점에서 몇주전(2021년 7월) 지멘스사의 C기반 설계 및 검증에 관한 온라인 세미나를 보게 됐었다. 여전히 C 언어 기반의 설계를 홍보하고 있는 걸 보며 감개무량 했다. 20년이 지났지만 아직도 할말이(잘난척 할 수) 있다니....

십년 사이에 HLS 기술이 많이 발전한 것 같다. 자일링스(Xilinx)사의 FPGA 설계 도구(개발용 소프트웨어를 이쪽에서는 'tool' 이라고 부른다)에 HLS가 포함 된지도 십여년은 된 것 같은데 최근 2021년 판을 보니 상당히 인상적이다. 게다가 디바이스 제약이 있긴 하지만 HLS 툴은 무료 아닌가! 마이크로소프트의 비주얼 스튜디오 C++ 도 무료, SystemC 는 원래부터 무료다. 최강 시뮬레이션 도구는 VHDL, Verilog, SystemVerilog 그리고 SystemC (GCC포함)을 모두 지원하는 멘토그래픽스(Mentor Graphics)사의 모델심(ModelSim)이라 할 것이다. 인텔의 알테라 FPGA 용으로 무료 판이 있긴한데 SystemC 는 빠져서 아쉽다.

안타깝게도 C/C++가 반도체 설계자들 사이에 여전히 인기가 없다 보니 널리 쓰이는 것 같지 않다. 2004년 SNUG에서 발표한 스튜어트 서덜랜드의 논문 'Integrating SystemC Models with Verilog and SystemVerilog Models Using the SystemVerilog Direct Programming Interface' (이 논문을 기억하는 이유는 참고문헌에 내가 언급되었기 때문임)에서 HDL 기술자에게 C++는 겁먹게 하는 대상이라고 언급 되었는데 지금도 그런지는 모르겠다. 가르치는 교육기관(대학이나 학원)이 있는지도 모르겠고....

마침 자일링스에서 HLS를 연습해 볼수 있는 좋은 교재가 있길래 이를 따라가 보기로 한다.

Vivado Design Suite Tutorial High-Level Synthesis UG871 (v2020.1) August 7, 2020
PDF / Design Files

몇가지 실습을 따라해본 소감은 대단한 발전이라는 생각이 들었다. 다만 검증 도구가 문제였다. C++나 Verilog, VHDL 같은 HDL도 모두 구문 규칙이 강직한 컴퓨팅 언어이므로 자동화된 변환이 가능 하겠지만, 검증은 말 그대로 고도의 작업이다. 설계물의 검증을 위해 시험 환경을 만들어 주어야 한다. 과연 이 시험 환경에 결함이나 헛점이 없길 바란다. 소프트웨어의 개발에서도 검증에 많은 투자를 한다. 하드웨어 개발시 검증은 전체 개발비(+시간)의 8할 이상이라고 한다. C언어로 기술된 것을 합성하여 얻은 RTL 설계물 역시 검증되어야 한다.

자일링스 HLS 도구에 C 로 작성된 검증 코드를 RTL 테스트벤치로 변환해 주는 도구도 포함되어 있다. C의 main() 을 읽어서 HDL 테스트 벤치를 생성해 주다니 감동적이다. 그들은 Co-Simulation이라고 자랑했다. 처음은 감동 이었다. 그런데 ......

구문해석기(apcc 라고한다)를 이용해 C 테스트 코드를 분석하여 설계물과 시험 환경 사이에 주고 받는 자료를 파일로 저장하는 부분이 삽입된 또다른 C를 생성하는 것이었다. 이렇게 생성된 C를 GCC로 컴피일 하여 실행시키면 테스트 결과 파일이 만들어 질테고 결국 diff 유틸리티로 입출력 벡터 파일을 비교해 보는 것으로 검증을 마친다. 변환된 테스트 벤치의 무결성을 보장받기 위해 자동화된 툴 체인을 갖춘점은 칭송할 만 하지만 Co-Simulation이라기엔 부족했다.

제대로 된 Co-Simulation 이라면 이래야 하지 않을까?

- 설계물의 C 코드에 변경 없을 것
- RTL 테스트 벤치에 실행형 바이너리로 결합될 것(Executable specification)
- 시뮬레이션 실행 중 실시간으로 입출력 검증이 이뤄질 것

이미 HDL과 C++를 동일한 환경에서 실행이 가능한 도구(C-HDL Mixed simulation)가 준비되어 있다. HDL에서 C 언어 인터페이스를 위해 Verilog의 PLI와 VPI, VHDL의 FLI와 VHPI, SystemVerilog 의 DPI 등이 표준화 되어있다. 하지만 이런 인테페이스 기준은 지나치게 복잡해서 학습 접근을 막고(반도체 하드웨어 설계자에겐 C++는 여전히 높은 벽인가?) 때로는 설계물의 C 코드를 변경을 요구하기도 한다. 게다가 HDL 전용 시뮬레이터가 아니면 실행 시킬 수 없다. 다행히 SystemC가 IEEE 1066-2011으로 표준 제정되다. SystemC는 C++를 라이브러리 수준에서 확장한 것이므로 GCC 나 비주얼 C++ 같은 표준 C++ 컴파일러 라면 실행 파일 생성이 가능하다.

어쨌든 자일링스 HLS 도구는 인상적이다. 그들이 제공한 튜토리얼을 따라가 보고 SystemC 로 Co-Simulation을 구성해 본다.

[참고]

[1] High Level Synthesis Blue Book
[2] 'Integrating SystemC Models with Verilog and SystemVerilog Models Using the SystemVerilog Direct Programming Interface
[3] 시스템수준 언어: SystemC & SystemVerilog
[4] Vivado Design Suite Tutorial High-Level Synthesis UG871
[5] 머신러닝(ML) 구현에서 ‘상위수준합성(High Level Synthesis, HLS)’이 주목받는 이유
[6] ESL 기반 설계 및 HLS 최신 동향 분석
[7] SystemC Verification with ModelSim
[8] AI/ML Accelerator Tutorial/C-Based Design & Verification
[9] Vivado Design Suite User Guide:High-Level Synthesis UG902 (v2021.1) May,4
[10] UltraFast Vivado HLS Methodology Guide UG1197 (v2020.1) June 3, 2020
[11] Vivado Design Suite Tutorial High-Level Synthesis UG871 (v2020.1) August 7, 2020, PDF / Design Files

------------------------------------------------------------------------------

목차 Table of Contents

    1장: 튜토리얼 개요 (Tutorial Description)

    2장: 고위합성 맛보기(High-Level Synthesis Introduction)
        실습 1: 고위합성 프로젝트
            단계 1: HLS 프로젝트 생성 (Create HLS Project)
            단계 2:  C 소스코드 검증 (Validate the C Source Code)
            단계 3: 고위합성 (High-Level Synthesis)
            단계 4: RTL 검증 (RTL Verification)
            단계 5: IP 제작 (IP Creation)
            요약: 자일링스 HLS 도구 의 흐름(Tool Flow)
            추가: SystemC Co-Simulation Testbench
        실습 2: Tcl 스크립트(Tcl Scripts)
        실습 3: 설계 최적화(Design Optimization)

    3장: C 설계의 바름 검증(C Validation)
        개요
        실습 폴터구조
        실습 1. GNUPLOT 를 이용한 도식화
        실습 2: GNUPLOT, Windows GDI+, SDL Lib 그리고 Python을 내장한 SystemC 테스트 벤치
            2-1. sc_fifo<T> 채널을 이용한 시스템 수준(System Level) 테스트 벤치
            2-2. sc_signal<T*>
            2-3. sc_signal<T>, 클럭 상세(clock-level data transfer) 데이터 전송
        실습 3. Arbitrary Precision Type

    4장: 인터페이스 합성(Interface Synthesis)
        개요
        실습 1. 블럭 수준 입출력 프로토콜(Block-Level I/O Protocol)
        실습 2. 포트의 입출력 핸드쉐이크 프로토콜(Port I/O Protocol)
        실습 3. 배열로 주어진 인수의 RTL/FIFO 인터페이스 구현(Implementing Array as RTL/FIFO Interface)
            3-1. 메모리 인터페이스 합성
            3-2. FIFO 인터페이스 합성
            3-3. 핸드쉐이크 없는 함수의 호출과 종료
            3-4. 중단없는 파이프라인
            3-5. 내부구조 선택: 파이프라인 구조 vs 병렬 구조
        실습 4. AXI4 인터페이스(Implementing AXI4 Interfaces)

    5장: 임의 정밀도 형(Arbitrary Precision Type)
        개요
        C++의 템플릿(template)
        실습 1. 부동소숫점 자료형으로 합성
        실습 2: 임의 정밀도 자료형으로 합성

    6장. 설계 분석 (Design Analysis)
        개요
        C 설계 검토 및 검증: 2차원 DCT(2-D Discrete Cosine Transform)
            단계 1. 최초 합성
            단계 2. 최상위 모듈에 파이프라인 지시(최고 클럭 성능)
            단계 3. 최상위 모듈에 파이프라인 억제 지시(최소 하드웨어 자원)
            단계 4. 반복문 최적화: 파이프라인 지시 및 메모리 분할
            단계 5. 병렬성 강화 최적화 (DATAFLOW)
            단계 6. 계층구조 최적화 (INLINE)

    7장. 설계 최적화(Design Optimization)
        개요
        실습 1: HLS 지시자의 적용에 따른 합성 결과 분석 
            단계 1. 병렬처리가 억제된 합성(최소 하드웨어)
            단계 2. 최하위 반복에 파이프라인 지시
            단계 3. 상위 반복에 파이프라인 지시
            단계 4. 배열 재정렬(ARRAY_RESHAPE)
            단계 5. FIFO 인터페이스
            단계 6. 함수 전체에 파이프라인 지시
        실습 2: 소스 코드 변경

    8장. 레지스터 전송 수준 설계(RTL Design)

8장. 레지스터 전송 수준 설계(RTL Design)

8장. 레지스터 전송 수준 설계(RTL Design) [소스 다운로드]

레지스터 전송 수준(RTL, Register Transter Level)에서 디지털 회로 설계를 정의하는 특징을 들자면,

- 클럭 상세(clock-cycle detail)
- 비트 상세(bit-width detail)

C++의 템플릿(template)으로 디지털 하드웨어의 객체(레지스터 register 와 전선 wire)를 임의 비트 크기 자료형으로 표현할 수 있다. 이번 예제는 비트 상세 설계된 duc(digital up counter)/dds(direct digital synthesis) 다.

예제는 C 설계의 객체들이 비트 상세형으로 기술되었다. 템플릿으로 11비트, 18비트, 23 비트, 45비트 등 정수를 다양하게 기술하고 있다. 높은 추상화 수준의 언어로 알고리즘을 비트 상세 기술하면 장점보다 단점이 많다. 고유 자료형과 호환성이 떨어지고 무엇보다도 충분히 성숙된 RTL 언어가 있는데 높은 추상화 수준의 언어를 사용할 필요가 없다. 그렇더라도 비트 상세가 유리할 때도 있는 법이다. 비트단위 연산이 많거나 제어 집중적인 설계에 유리하다. 또한 추상성이 상이한 여러 모듈이 혼재하는 시스템 수준 설계와 통합 그리고 검증 환경(RTL/HDL과 Co-Simulation) 구축에 유리하다. C++ 언어로 작성된 테스트 벤치의 유연함과 실행 속도는 RTL/HDL에 비할바가 아니다. 추상화 수준이 높은 설계 도구(언어)라 할지라도 낮은 수준의 설계 방법론을 수용해야 하는 것은 필수 요건이다. 최상위 시스템 수준 설계 언어인 C++는 소프트웨어 개발은 물론 SystemC 크래스 라이브러리를 활용하여 하드웨어의 RTL 논리식 수준까지 가능하다.

예제 duc()는 4개의 하위 함수를 가지고 있다. 다른 합성 옵션 없이 입출력 인터페이스만 지정해 주고 합성했다.

자일링스의 Vitis HLS Tutorial 문서 UG871과 함께 제공된 소스에 문제가 있어서 수정 했다. 비티스 HLS 2021.1에서는 C 형식 임의 정밀도 'ap_cint.h' 가 지원 되지 않는듣하다. 임의 비트 폭 정수형 재정의(typedef) 문이 구문 오류를 낸다. 게다가 이 형식은 SystemC와 호환성도 없다.

typedef uint(N) acc_t;
typedef int18 srrc_data_t;

C 언어의 임의 비트 정수형을 비티스 HLS에서 정의한 C++의 ap_int<> 형식으로 바꿨다. 이 템플릿 자료형은 SystemC의 sc_int<>와 기능적으로 호환된다.

#ifdef SYSTEMC_LIB
#include <systemc.h>
#define ap_int      sc_int
#define ap_uint    sc_uint
#else
//#include "ap_cint.h"
#include <ap_int.h>
#endif

typedef ap_uint<N> acc_t;
typedef ap_int<18> srrc_data_t;

원 소스 코드를 변경하였으므로 함께 제공 되었던 테스트를 거쳐야 한다. Vitis HLS의 설계절차를 모두 수행하여 Co-Simulation 까지 통과했다. 수정한 C++ 소스 코드가 원본과 일치한다는 뜻이다.

RTL/HDL-SystemC Co-Simulation 검증 환경을 구성하였다. 비트 폭 상세(bit-width detail) C++ 설계물은 HLS를 거쳐 클럭 상세(clock-cycle detail)이 추가된 RTL이 되었다. RTL과 C++ 설계물의 혼합 시뮬레이션은 최상위 추상화 수준에서 논리식 수준까지 폭넓게 지원하는  SystemC 검증 환경에서 이뤄진다.

데이터 시각화

파형(waveform) 보기와 통과 메시지(assertion message) 출력은 RTL 설계의 흔한 검증 방식이다. 하지만 수많은 출력을 문자로 보기엔 뭔가 서운하다. 출력 숫자들이 궁금하여 그림으로 보니 예제의 의도가 파악 되었다. 디지털 주파수 합성기 였다.


---------------------------------------------------------------------------------
고위 합성 튜토리얼(High-Level Synthesis Tutorial)
[목차][이전][다음]


2021년 10월 14일 목요일

7장. 설계 최적화 (Design Optimization)

7장. 설계 최적화 (Design Optimization)

개요

실습 1: HLS 지시자의 적용에 따른 합성 결과 분석 
    단계 1. 병렬처리가 억제된 합성(최소 하드웨어)
    단계 2. 최하위 반복에 파이프라인 지시
    단계 3. 상위 반복에 파이프라인 지시
    단계 4. 배열 재정렬(ARRAY_RESHAPE)
    단계 5. FIFO 인터페이스
    단계 6. 함수 전체에 파이프라인 지시

실습 2: 소스 코드 변경

[소스다운로드]

----------------------------------------------------------------------------------------------------

개요

C 코드에 적절한 합성 지시자를 적용하여 최적 성능의 RTL/HDL을 얻는 것이 고위 합성(HLS)의 목표다. 최적성능은 속도(인터벌 클럭 소요 갯수)와 하드웨어 사용량으로 평가된다. 고위 합성기는 먼저 반복문 또는 함수의 작동을 완료하는데 소요되는 클럭 수, 즉 레이턴시를 최소화하는데 총력을 기울인다. 이를 위해 실행문들 사이에 변수들의 의존 관계를 따져 병렬 실행이 가능하도록 분리해내고 의존 관계가 존재하는 경우 파이프라인 처리 구조를 찾는다.

C로 기술된 알고리즘에서 병렬성과 파이프라인 구조가 항상 선명하게 드러나는 것은 아니므로 구조를 파악하여 적절한 지시자를 주어야 한다.

- 병렬성(parallelism): 병렬처리가 많아 질수록 하드웨어의 규모는 기하급수적으로 늘어나지만 HLS의 근본 목적이 속도 성능을 높이는 것이므로 최대한 병렬성을 추구한다. 따라서 가장 먼저 병렬성을 찾기 위해 실행문에서 의존관계를 따진다. 많은 연산이 포함된 알고리즘 일수록 배열 변수를 활용하게 되는데, 이 배열 변수들은 메모리로 구현하여 하드웨어 용량을 절약 한다. 하지만 다수의 값을 동시에 불러오지 못하는 메모리는 병렬처리를 저해하는 요소가 될 것이다.

- 파이프라인(pipeline): 실행문 사이의 의존 관계가 있는 경우 파이프라인 구조를 취하여 클럭당 처리량(throughput)을 증대 시킨다. 한 클럭당 한개 데이터를 처리할 수 있을 때 최적의 성능을 보장할 수 있겠으나 항상 이를 만족하지 못하는 경우 데이터 흐름에 병목이 생겨 정체가 일어난다. HLS에 파이프라인 지시를 주는 위치에 따라 레이턴시와 인터벌 클럭수가 다른 것은 병렬 구조의 차이 때문이다.

예제는 3x3 크기의 행렬 곱셈기(matrix multiplier)다. 두 행렬은 함수 외부에서 2차원 배열로 주어지며 행렬곱은 2차원 배열로 출력된다. 입력과 출력의 2차원 배열이 RAM 메모리에 저장되었다고 하자. 함수 matrixmul()의 내용은 행렬 곱셈을 수행하는 3중 반복문으로 구성되었다.

[맨위로]

-----------------------------------------------------------------------------------------------------

단계 1. 병렬처리가 억제된 합성(최소 하드웨어) 

HLS의 PIPELINE 지시자는 반복구문에서 변수들 사이의 의존성을 따져 병렬성을 파악하고 의존성이 있을 경우 파이프라인 구조를 만들어낸다. 이번 단계는 최소 하드웨워 자원을 사용하는 구조를 살펴보기 위해 행렬 곱셈기 함수에 PIPELINE을 억제 시키는 지시를 주고(PIPELINE off) 합성해 보자. 아울러 HLS가 다중 반복문을 어떻게 처리 하는지 스케쥴 뷰어를 통해 확인해 본다. 

PIPELINE이 억제되어 합성되었으므로 3중 반복문이 그대로 존재한다. 각 반복문 별 레이턴시 계산해 보면 아래와 같다.

Product 라벨이 붙여진 가장 안쪽의 k-반복문 내의 실행문이 3회 반복(trip count)된다. 반복되는 실행문이 1개에 불과하나 복잡한 구성을 하고 있다. 메모리 a와 b에서 읽기, 그리고 res에 쓰기가 있으며 곱셈과 누적을 수행한다. 메모리에 접근하려면 2 클럭이 소요되는데 읽기 혹은 쓰기 전에 주소가 선행되어야 하기 때문이다. 1개의 실행문이 1클럭내에 실행될 수 없다. 합성된 하드웨어의 반복 레이턴시(iteration latency)가 7이며 3회 반복(trip)하므로 Product 라벨의 레이턴시는 15다.

Col 라벨 역시 3번 반복한다. 하위 Product 의 레이턴시 15에 반복의 시작과 끝을 확인하는 상태가 각각 추가되어 17이다. 따라서 Col의 레이턴시는 51이다.

최상위 Row 반복의 경우 한번 진행으로 끝나므로 재시작할 필요가 없이 종료 조건만 확인한다. 따라서 하위 Col 반복을 3회 진행하고 종료 확인을 목적으로 1개 상태(클럭)가 추가 되어 161 클럭의 레이턴시를 갖는다.

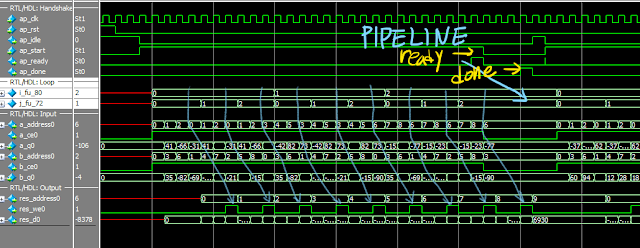
실제 HLS를 통해 수행된 스케쥴은 다음과 같다. k-반복내의 실행문에 병렬성이 있으나 병렬구조는 억제되었다. k와 j-반복은 재반복 되고 i-반복은 한 회로 끝나는스케쥴을 볼 수 있다.

RTL/HDL-SystemC Co-Simulation

[맨위로]

-----------------------------------------------------------------------------------------------------

단계 2. 최하위 반복에 파이프라인 지시

PIPELINE이 억제되어 합성되면 실행문에 병렬성이 있더라도 병렬구조로 만들어 내지 않는다. 비록 전체 병렬 구조가 배제되어 더라도 k-반복 내에 파이프라인 구조가 가능하다.

k-반복의 스케쥴 개념도는 아래와 같다. 입력 a와 b가 각각 별도의 메모리 블럭에 구현되어 있어서 동시 읽기가 가능하다. 단계1에서는 파이프라인을 허용하지 않았으므로 반복 인터벌 6을 k-반복에서 3회, j 반복에서 3회, i 반복을 3회하여 총 레이턴시가 162가 된다. 

k-반복에 파이프라인을 허용한 하드웨어의 경우 ii=1이 가능하므로 인터벌 1을 가지고 k, i, j를 반복하여 레이턴시는 27이다.

스케쥴 뷰어로 확인해 보자.

만일 k-반복을 병렬처리 구조로 바꿀 경우 복수의 a 와 b를 동시에 읽어오는 상황이 생길 수 있다. 제한된 입출력 포트를 가진 RAM 메모리 자원은 동시에 다수 데이터를 읽고 쓰기가 불가능하므로 이런 병렬처리 요구가 불가하다. 따라서 반복을 시작하기 전에 순차적으로 RAM 접근을 진행해게 되어 ii가 1 이상을 넘는 바이얼레이션이 일어난다. 이를 제한된 자원으로 인한 ii-바이얼레이션(limited resource ii-violation) 이라 한다. 이에 대해서 다음 단계에서 다룬다.

RTL/HDL-SystemC CoSimulation 으로 확인해보면 다음과 같다. 파이프라인이 작동 되는 것을 알 수 있다.

[맨위로]

----------------------------------------------------------------------------------------------------

단계3. 상위 반복에 파이프라인 지시

3중 반복 구문에서 j-반복에 PIPELINE 지시하면 하부에 놓인 k-반복은 병렬 구조로 풀어낸다.

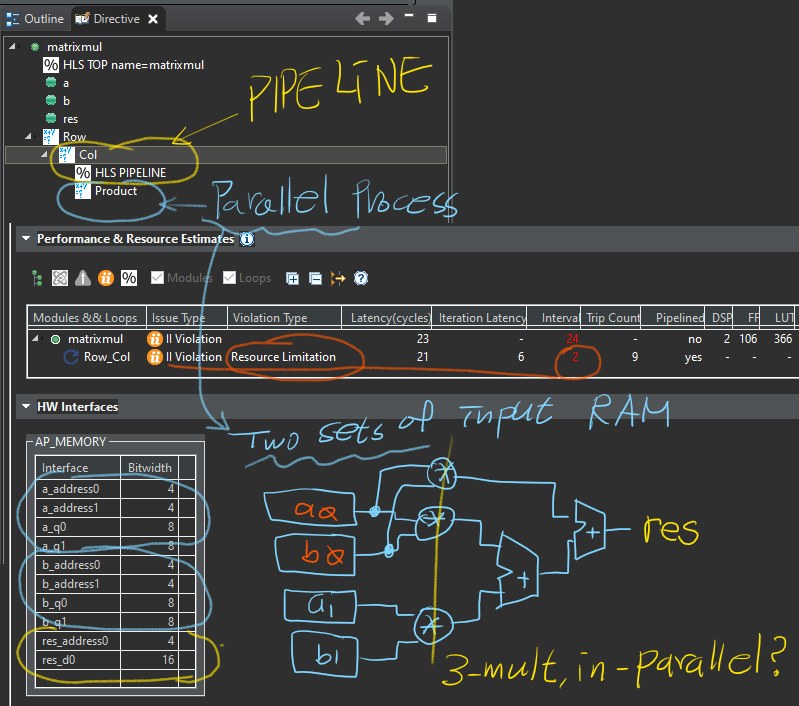
합성된 연사자들을 보면 3개의 곱셈기를 동원해 병렬 구조를 구성하고 있으나 RAM 메모리에 저장된 입력을 동시에 읽어올 수 없는 문제가 발생한다. 입력 a[]와 b[]는 병렬구조에 대응하기 위해 복제된 2쌍의 RAM에서 공급되는 구조다.

하지만 2쌍의 RAM으로 병렬구조의 곱셈기에 3-입력이 동시에 제공될 수 없어서 나누어 읽어와야 하므로 j- 반복을 시작하기 전에 두번째 a 값을 읽기위해 한 클럭을 더 소모하여 ii=2가 되어 바이얼레이션을 일으킨다.

PIPELINE 구조는 한 클럭 당 한개의 데이터 처리가 원칙이다. 반복을 시작하기 전 준비에 1 클럭 이상이 필요하면 ii 바이얼레이션이 발생한다. 바이얼레이션은 합성 실패가 아니다. 규칙에서 벗어났다는 의미다. 타이밍 바이얼레이션은 반드시 보완되어야 하지만 ii 바이얼레이션은 채택하기 여부에 달렸다.

RTL/HDL-SystemC CoSimulation

 [맨위로]

-----------------------------------------------------------------------------------------------------

단계 4. 배열 재정렬(ARRAY_RESHAPE)

두 쌍의 메모리를 가지고 최하위 k- 반복에 병렬 구조를 구성했더라도 RAM의 동시 읽기가 불가하여 파이프라인 규칙을 따르는 것이 불가했다. 그렇다면 ii=2의 원인이 됐던 입력 배열 변수 a[] 를 병렬로 펼쳐놓자. 2차원 배열을 모두 펼치면 9개(MAT_A_ROWS*MAT_A_COLS) 입력이 될 것이다. 한번에 3 입력이 필요하므로 ARRAY_PARTITION=complete 대신 ARRAY_RESHPE 지시자를 적용한다. 배열 입력 a[]

스케쥴 뷰어, ii=1

RTL/HDL-SystemC CoSimulation

Row와 Col 라벨이 붙은 두 반복 문이 결합되었다. 합성보고에 나온 대로 반복 레이턴시(iteration latency)는 6, ii=1의 파이프라인이 9번 진행(trip count) 되어 함수의 동작이 종결됨을 알 수 있다.

배열 입력 a[]와 b[] 그리고 출력 res[]의 주소가 직렬(stream)이다. 입출력 인터페이스를 메모리 대신 FIFO 가 가능해 보인다. 시스템 설계에서 모듈간 인터페이스로 메모리 모다 FIFO 채널을 선호한다. 메모리의 경우 주소 생성과 읽기/쓰기 제어를 위해 클럭을 소모할 뿐 더러 데이터 패스 지연이 긴 편이다. 무었보다 FIFO 인터페이스 채널은 데이터 발생 갯수에 동기를 맞춰야 하는 부담이 적다. 위 예제에서 봤듯이 연산을 모두 끝내기 까지 a[]의 데이터 요구 횟수는 3번인 반면 b[] 는 9회에 이른다. 만일 FIFO 였다면 주소 생성에 번거로 움을 덜 수 있다. 제어 FSM의 상태수도 단순해 지고 그만큼 소요되는 하드웨어도 준다.

[맨위로]

----------------------------------------------------------------------------------------------------

단계 5. FIFO 인터페이스

입출력 인수 a, b 그리고 res에 FIFO 인터페이스 지시(INTERFACE=ap_fifo)를 주고 합성했다. 합성 결과 보고를 살펴보니 기대하는 효과를 얻지 못했고 ii 바이얼레이션을 냈다.

HLS 경고(Warning)를 살펴보자. 바이얼레이션은 실패(fail)가 아니므로 경고에 포함되어 있다.

WARNING: [HLS 200-880] The II Violation in module 'matrixmul' (loop 'Row_Col'): Unable to enforce a carried dependence constraint (II = 1, distance = 1, offset = 1) between fifo write operation ('res_write_ln65', matrixmul.cpp:65) on port 'res' (matrixmul.cpp:65) and fifo write operation ('res_write_ln61', matrixmul.cpp:61) on port 'res' (matrixmul.cpp:61).

소스 코드의 61번 줄과 65번 줄의 fifo 쓰기를 II=1로 불가함.

WARNING: [HLS 214-142] Implementing stream: may cause mismatch if read and write accesses are not in sequential order on port 'res' (matrixmul.cpp:54:0)

WARNING: [HLS 214-142] Implementing stream: may cause mismatch if read and write accesses are not in sequential order on port 'b' (matrixmul.cpp:54:0) 

입력 b와 출력 res의 fifo 채널 인터페이스에 접근이 순차적이지 않음.(FIFO는 RAM 처럼 무작위 주소지정 할 수 없다.)

WARNING: [HLS 214-237] The INTERFACE pragma actions in object field. If on struct field, disaggregate pragma is required;  If on array element, array_partition pragma is required. If no, this interface pragma will be viewed as invalid and ignored. In function 'matrixmul(char (*) [3], char (*) [3], short (*) [3])' (matrixmul.cpp:54:0)  matrixmul_prj:

WARNING: [HLS 214-281] Estimating pipelined loop 'Col' (matrixmul.cpp:59:12) in function 'matrixmul' with estimated II increased from II=1 to II=2 because of limited port on variable 'res' (matrixmul.cpp:59:12)   matrixmul_prj:

출력 포트 res 에 입출력의 동시 요구에 제한이 있으므로 ii=1 에서 ii=2 로 변경

WARNING: [HLS 207-5542] the expression for 'port' option is invalid, top argument that is ap_fifo/axis port may require the 'volatile' qualifier to prevent the compiler from altering array accesses and/or modifying the desired streaming order:

[맨위로]

----------------------------------------------------------------------------------------------------

단계 6. 함수 단위로 PIPLINE 지시

반복문 마다 세분하여 합성 지시를 주어 최적의 결과를 얻어내려면 상당한 노력이 든다. 때로는 함수 전체에 합성 지시를 내릴 수도 있다.

합성 결과표를 근거로 내부 구조를 추정해 보면 다음과 같다. k- 반복을 3개의 곱셈을 갖는 병렬 파이프라인 구조로 풀어내기 위해 입력 인수 a[]와 b[] 그리고 출력 res[]가 모두 2중 RAM 으로 구현 했다. 2중 i-반복(Row)과 j-반복(Col)은 9개의 3입력 병렬 곱셈기 구조로 펼쳐 놓은(flatten) 구조다.

스케쥴 뷰어를 보면 i, j, k 반복이 아예 없이  3중 반복문이 한데 뭉친 병렬처리 파이프라인 구조다. 클럭 성능을 최대한 끌어올리고 있으나 하드웨어 사용량이 매우 높다. HLS의 최우선 목표는 클럭 성능을 높이는 것임을 알 수 있다.

RTL/HDL-SystemC CoSimulation

RAM 메모리에서 한번씩 읽어들인 입력인수를 매우 영리하게 사용하여 3x3 행렬에 필요한 27번의 곱셈을 수행한다. 인수 a[] 와 b[]를 읽어들이는 순서(주소)에 주목해 보자. 그리고 한번씩 읽어들인 인수를 쉬프트 시켜 3병렬 곱셈을 9회 반복하는 연산을 10 클럭(레이턴시는 11)만에 완료하고 있다.


외부에서 제공되는 인수를 반복적으로 다시 읽지 않는 구조는 하드웨어의 모듈(라이브러리)화 측면에서도 매우 중요하다. 기능을 완료하기 까지 입출력 횟수를 줄여 자체 레이턴시를 줄일 뿐만 아니라 외부 모듈과의 의존성을 낮출 수 있기 때문이다. 시스템 설계에서 FIFO 채널 인터페이스를 추구하는 이유 이기도 하다.

그나저나 C의 반복문에서 병렬 구조를 끌어 낼 뿐만 아니라 입출력 인터페이스까지 고려해 스케쥴 까지 짜는 HLS의 최적화의 능력은 대단하다.

[맨위로]

-----------------------------------------------------------------------------------------------------

실습 2: 소스코드 변경

시스템에는 다양한 작동 모듈이 집적된다. 모듈간 입출력 데이터의 생성과 소모율이 다를 수 밖에 없다. 시스템의 통신을 관장하는 전역 컨트롤러(또는 스케줄러)는 매우 정교해야 한다. 구성이 다양할 수록 스케쥴러의 복잡성이 높아지고 집적(integration)하는 과정에서 하위 모듈의 변경 교체에 대응하기도 어렵다. 이럴 때 선택할 수 있는 방법이 다수 마스터를 허용(버스 스케줄러 scheduler, 아비터 arbiter 를 가진)하는 시스템 버스의 채택이다. 전송전 버스점유 허용 절차에 클럭 소모가 많아 소규모 입출력 혹은 클럭단위 입출력 모듈의 경우 불리하다. 버스트(스트림) 트랜잭션에 유리하다.

전역 스케줄러 없이 하위 모듈끼리 알아서 통신을 처리하는 방법으로 FIFO 인터페이스 채널이 있다. 모듈간 복잡한 핸드쉐이크가 필요 없다. 모듈은 통신 채널에 빈공간이 있는지, 읽어올 데이터가 쌓였는지 확인할 뿐 상대 모듈이 언재 통신할 준비가 되었는지 감시할 필요 없다. 시스템 관리자는 그저 구성 모들의 성능(쓰루풋, throughput)을 다그칠 뿐이다.

3x3 행렬 곱셈기를 ii=1인 파이프라인 구조에 입출력에 FIFO 인터페이스 채널로 합성해 보자. 앞서 단계 5에서 입출력 포트에 INTERFACE=ap_fifo 지시를 주었으나 성공하지 못했다. 함수 내 중복 반복문에서 포트를 무작위(random) 주소 접근으로 읽은 탓이다. 게다가 반복적으로 다시 읽기까지 하는 구조로는 fifo 인터페이스는 불가하므로 소스를 수정해 주기로 한다. 입출력을 미리 한번 읽어두는 방식으로 바꿔 놓고 k- 반복의 누산(accumulation)을 출력 포트에 누산시키지 않고 내부 임시 변수를 쓰도록 한다. FIFO 인터페이스의 요건에 맞도로 수정된 C 소스코드는 아래와 같다.

합성 결과 보고를 보면 인터페이스에 문제가 있어 보인다. 입력 b[] 와 출력 res[]는 FIFO 인테페이스로 합성되었으나 입력 a[]는 여전히 메모리 인터페이스다.

생성된 RTL/HDL을 가지고 SystemC CoSimulation 을 해보면 a[]의 주소도 순차적이며 다시 읽기도 없다. 메모리 인터페이스에서 FIFO로 변경되지 않은 이유는 알 수 없다. ARRAY_RESHAPE에 dim=2 로 한 것이 원인 것으로 보인다.

[맨위로]

---------------------------------------------------------------------------------
고위 합성 튜토리얼(High-Level Synthesis Tutorial)
[목차][이전][다음]


2021년 10월 8일 금요일

6장. 설계 분석-II (Design Analysis-II)

6장. 설계 분석-II (Design Analysis-II)

개요
C 설계 검토 및 검증: 2차원 DCT(2-D Discrete Cosine Transform)
단계 1. 최초 합성
단계 2. 최상위 모듈에 파이프라인 지시(최고 클럭 성능)
단계 3. 최상위 모듈에 파이프라인 억제 지시(최소 하드웨어 자원)
단계 4. 반복문 최적화: 파이프라인 지시 및 메모리 분할
단계 5. 병렬성 강화 최적화 (DATAFLOW)
단계 6. 계층구조 최적화 (INLINE)

-----------------------------------------------------------------------------------------------------

단계 3. 최상위 모듈에 파이프라인 억제 지시(최소 하드웨어 자원) [소스 다운로드]

C 설계 함수 dct()를 구성하는 하위함수들에 기본으로 들어갔던 파이프라인 지시를 억제 시켜 놓고 합성해 보자. 하드웨어를 최소로 쓰는 구조가 될 것이다.

설계 전반에 걸쳐 2중 for 반복문이 있고 안쪽 반복(inner Loop)에서 자원 공유된 탓에 소요된 하드웨어 자원의 양이 최소화 되었으나 인터벌이 너무 커서 고속처리를 원했던 목적에 한참 뒤진다.

시뮬레이션으로 확인 해보면 한개 입출력 읽기와 쓰기에 3클럭을 쓰고있다. 특히 출력 쓰기 타이밍을 보면 8번째 마다 쓰기에 한 클럭이 더 소요되는데 반복문 탈출 검사가 필요 했기 때문이다. 확실히 파이프라인 처리는 전혀 하지 않고 있음을 알 수 있다.

굳이 스케쥴 뷰어(schedule viewer)를 보면서 확인 할 필요는 없겠지만 '실습'이니 만큼 반복문이 어떻게 합성되는지 보기나 하자. 메모리에 출력 데이터를 써넣는 부분의 스케쥴이다. 원 소스에 레이블을 붙여 놓으면 분석할 때 도움이 된다. 특히 반복문에 레이블이 붙이도록 하자.

스케쥴 표를 보고 있노라면 합성기가 상당히 잘 처리하고 있는 것을 볼 수 있다. 마치 C에서 변환된 어셈블리(assembly)어를 보는 느낌이다. 스케쥴 뷰어에서 녹색으로 표시된 화살표(green arc)은 되돌림 반복이다. 파이프라인 구조를 위해서 녹색 그래프를 없애야 한다. 스케쥴 표를 보면 역방향 그래프는 모두 2중 for 반복문에서 안쪽 반복에 걸려 있다.

-----------------------------------------------------------------------------------------------------

단계 4. 반복문 최적화: 파이프라인 지시 [소스 다운로드]

수많은 합성 지시를 줄 수 있다. 일일이 다 적용해보기도 좋지만 시간이 오래 걸릴 뿐더러 합성 지시가 기대와 정반대 결과를 내기도 한다. 따라서 지시를 주고 결과 분석 과정을 통해 최적의 합성 결과를 얻기 위해 전략적으로 접근해 보자. 이번 단계는 반복문에 파이프라인 합성 지시를 하고 그 결과를 분석해 보자. 반복문이 중첩되어 있다면 안쪽 반복문을 먼저 파리프라인 처리를 지시하는것이 일반적인 접근이다. 단계 1의 최초 합성은 dct()를 구성하는 하위 함수의 2중 반복 중 안쪽 반복에 모두 PIPELINE 을 적용하고 얻은 결과다.

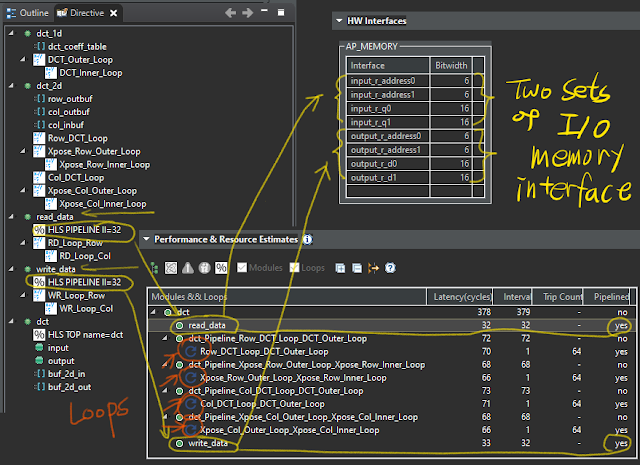
4-1. 입출력 데이터 처리 함수 read_data()와 write_data()에 PIPELINE 지시

다중반복(nested loop)이 있는 경우 가장 안쪽 반복에 PIPELINE 을 적용하는 전략이 항상 좋은 결과를 낳는 것은 아니다. 먼저 데이터 입력 부분부터 병렬성을 높여 보기로 하자. read_data()는 dct() 전과정에서 파이프라인의 시작점이기도 하다.

read_data() 와 write_data()의 외측 반복에 준 PIPELINE 지시자가 효과가 있었다. 레이블 앞에 있던 반복 표시(둥근 화살표)가 모두 사라졌고 부분 레이턴시도 반으로 줄었다. 병렬성을 높이려고 입출력 메모리 인터페이스가 두쌍이 된 점에 유의하자.

4-2. 1차원 DCT dct_1d()에 PIPELINE 지시

가장 많은 연산과 반복이 포함된 함수는 1차원 DCT, dct_1d() 다. 특히 이 함수는 2차원 DCT 를 위해 8행에 대한 처리를 두번 실행되고 양쪽으로 2차원 메모리 트랜스포스를 두고 있다. 따라서 2차원 DCT 내에는 총 16번의 1차원 DCT가 실행 된다.

메모리 트랜스포스는 알고리즘의 특성상 앞의 1D-DCT 가 완료되기 전까지 시작할 수 없다. 단독으로 파이프라인 처리가 불가하다.

PIPELINE 지시를 dct_1d() 함수에 주는 위치에 따라 합성 결과가 달라진다. 병렬처리 구조 변경을 함수 내부에 제한하거나 연결된 외부 함수까지 영향을 미칠 수 있다. 클럭 성능이 향상되면 높은 병렬 성을 추구하는 구조가 되어 하드웨어 자원 사용량은 증가한다.

(1) dct_1d() 내의 외곽 반복 DCT_Outer_Loop에 PIPELINE 를 지시한 경우:

dct_1d()는 레이턴시 16을 갖는 파이프라인 처리되지만 8행 반복 Row_DCT_Loop 와 Col_DCT_Loop 가 파이프라인에서 제외되어 전체 레이턴시 552로 성능이 오히려 악화됨. 파이프라인에서 제외된 반복에서 사용하는 배열변수는 레지스터 메모리 대신 BRAM을 활용 한다.

(2) dct_1d() 전체에 PIPELINE 를 지시한 경우:

dct_1d()가 레이턴시 16을 갖는 파이프라인, 이 함수와 연관된 8행 반복 Row_DCT_Loop 와 Col_DCT_Loop 가 파이프라인 구조를 갖진 못했으나 dct_1d()와 결합되어 전체 레이턴시 176으로 향상됨. 하드웨어 자원 사용량 3배가량 대폭 증가함. 모든 배열 변수들이 레지스터 변수로 구현 되었기 때문에 BRAM 사용은 없다. 

(3) dct_1d()함수와 외곽 반복 DCT_Outer_Loop에 PIPELINE 을 동시에 지시한 경우:

dct_1d()의 내부 최적화와 외부 8행 반복을 분리 합성 함. dct_1d()의 내부 레이턴시 7, 외부 8행 반복 Row_DCT_Loop 와 Col_DCT_Loop 가 레이턴시 1로 8번 반복함. 전체 레이턴시 265. 레이턴시와 하드웨어 사용량의 타협이 이뤄짐. 배열 변수 일부가 BRAM으로 구현 되었다.

4-3. 메모리 트랜스포스 반복에 PIPELINE 지시

dct_1d()에 준 PIPELINE 이 클럭 성능 면에서 효과가 있었으므로 이를 선택하고 양쪽에 끼고있는 트랜스포스의 외곽 반복에 같은 합성 지시를 주었지만 좋은 결과를 얻지 못했다. 합성 결과를 보면 전체 레이턴시가 176에서 272로 올라 갔고 하드웨어 사용량은 오히려 증가했다. 앞서 이뤄진 1차원 DCT의 8행 반복 이후 트랜스포스 메모리 사이에 병목이 있다는 바이얼레이션이다.

메모리 병목을 해결하기 위해 dct_1d()와 트랜스포스 사이의 2차원 배열을 분할(array partition)해 주어 바이얼레이션이 해결했다.

최종적으로 얻은 dct()의 레이턴시가 138 목표치 130보다 조금 크다. 최초 합성(단계1)에 비해 레이턴시는 430에서 138로 줄었고 하드웨어 사용량은 6배가량 증가 했다.

고성능 합성(단계2)의 레이턴시 69에 비해 두배지만 하드웨어 사용량은 1/4 수준이다. 클럭 성능과 하드웨어 사용량 사이의 적당한 타협이다.

각 단계에서 사용된 배열 변수들의 구현 방식에 주목해야 한다. 파이프라인 처리가 강화 될 수록 대규모 배열 변수에 BRAM 대신 LUT 내의 플립플롭으로 구현되어 하드웨어 사용량이 급격히 증가한다. FPGA 처럼 미리 배치된 경우라면 어짜피 있는 자원 그대로 활용할 테지만 ASIC 이라면 심각히 고려되어야 한다. HLS 합성 옵션(지시자)에 따라 레이턴시와 하드웨어 사용량 변화폭이 상당 함에도 FPGA에서 이를 검토대상에 넣고 받아들이는 이유는 미리 배치된 반도체 부품이기 때문이다. ASIC 을 목표로 한다면 저장소에 RAM/ROM을 활용 할지 플립플롭으로 구현할지 명확히 해주므로 옵션 변화에 따른 성능차는 작다. 대용량 FPGA를 목표로 하는 HLS의 경우 하드웨어 자원 활용을 최대한 허용하므로 상대적으로 합성이 수월한 편이라고 할 것이다.

-----------------------------------------------------------------------------------------------------

단계 5. 병렬성 강화 최적화(DATAFLOW) [소스 다운로드]

앞선 단계까지 dct_2d()를 구성하는 하위 함수들에 대하여 최적의 PIPELINE 합성을 찾았다. 최종적으로 얻은 dct()의 구성은 read_data(), write_data() 그리고 dct_2d() 다. 세 하부 블럭들을 묶어 병렬 실행성(parallelism)을 찾아 보기 위해 DATAFLOW 지시자를 적용해 보자.

인터벌이 139에서 72로 줄었다. dct()를 구성하는 세 하위 모듈들의 인터벌을 모두 더한 것보다 적다. 전체 인터벌과 가장 많은 클럭을 쓰는 dct_2d 모듈의 인터벌이 같다. 세 모듈들이 병렬로 실행되게 되었다는 뜻이다.

만일 dct_1d의 출력 버퍼와 트랜스포스 메모리를 합쳤더라면 메모리 자원을 절약하고 트랜스포스 동작이 아예 없어져서 소요 클럭도 줄일 수 있었을 것이다. 하지만 한 메모리에 대한 열 쓰기(column read)와 행 읽기(row write)를 동시에 하기는 불가하므로 하위 구성 모듈간 병렬 처리는 없다. 따라서 병렬처리로 얻은 인터벌 72 대신 32+71+32=135 에서 두번의 트랜스포스 처리에 소요된 16(=8+8, 외곽 반복 횟수)을 뺀 인터벌은 119 다.

하위 모듈 병렬처리를 RTL/HDL-SystemC Co-Simulation으로 확인해 보자. 최초 레이턴시 137 클럭 이후 read_data와 write_data 모듈이 dct_2d와 병렬 처리되면서 인터벌이 72로 반복된다. 2차원 데이터는 입력 버퍼 buf_2d_in[][]와 출력 버퍼 buf_2d_out[][] 그리고 트랜스포스 col_in_buf[][]의 3단계에서 저장된다. 따라서 병렬 처리 후 출력 데이타는 읽기와 3단 차이를 두고 반복된다는 점도 유의하자. 최초 레이턴시 입력에 대한 출력 후 인터벌 출력 사이의 출력은 무효한 출력이 있다.

입출력 메모리 RAM의 주소도 가지런 해졌다.


-----------------------------------------------------------------------------------------------------

단계 6. 계층구조 최적화(INLINE)

계층 구조화(hierarchy)는 소프트웨어 개발에서 함수를 라이브러리화 하여 재사용성을 높여 코드 메모리의 절약을 위한 기법이 될 수 있지만 하드웨어에서는 의미없다. 인터벌을 가장 많이 차지하는 dct_2d() 를 dct()의 하위 모듈에서 끌어 올려 평탄화 시켜 보자. 하위 모듈을 반복적으로 호출 하느라 소요되는 클럭을 줄일 수 있다.

주: 인터벌이 32로 줄긴 했으나 이는 어디까지나 병렬 처리하는 하위 모듈 중 가장 긴 인터벌을 차지하는 숫자일 뿐, 실용성 없는 숫자다. 32 클럭 내에 하위 모듈들의 병렬 실행 스케쥴을 잡기도 어려울 뿐만 아니라 입출력 메모리를 읽기에도 빠듣하다. 32클럭마다 계속 읽어온다면 외부에서 입출력 데이터를 저장해줄 틈이 없다. 이럴때 메모리 입출력 대신 FIFO를 쓰는 것이다.

---------------------------------------------------------------------------------
고위 합성 튜토리얼(High-Level Synthesis Tutorial)
[목차][이전][다음]