Translate

2021년 10월 14일 목요일

7장. 설계 최적화 (Design Optimization)

7장. 설계 최적화 (Design Optimization)

개요

실습 1: HLS 지시자의 적용에 따른 합성 결과 분석 
    단계 1. 병렬처리가 억제된 합성(최소 하드웨어)
    단계 2. 최하위 반복에 파이프라인 지시
    단계 3. 상위 반복에 파이프라인 지시
    단계 4. 배열 재정렬(ARRAY_RESHAPE)
    단계 5. FIFO 인터페이스
    단계 6. 함수 전체에 파이프라인 지시

실습 2: 소스 코드 변경

[소스다운로드]

----------------------------------------------------------------------------------------------------

개요

C 코드에 적절한 합성 지시자를 적용하여 최적 성능의 RTL/HDL을 얻는 것이 고위 합성(HLS)의 목표다. 최적성능은 속도(인터벌 클럭 소요 갯수)와 하드웨어 사용량으로 평가된다. 고위 합성기는 먼저 반복문 또는 함수의 작동을 완료하는데 소요되는 클럭 수, 즉 레이턴시를 최소화하는데 총력을 기울인다. 이를 위해 실행문들 사이에 변수들의 의존 관계를 따져 병렬 실행이 가능하도록 분리해내고 의존 관계가 존재하는 경우 파이프라인 처리 구조를 찾는다.

C로 기술된 알고리즘에서 병렬성과 파이프라인 구조가 항상 선명하게 드러나는 것은 아니므로 구조를 파악하여 적절한 지시자를 주어야 한다.

- 병렬성(parallelism): 병렬처리가 많아 질수록 하드웨어의 규모는 기하급수적으로 늘어나지만 HLS의 근본 목적이 속도 성능을 높이는 것이므로 최대한 병렬성을 추구한다. 따라서 가장 먼저 병렬성을 찾기 위해 실행문에서 의존관계를 따진다. 많은 연산이 포함된 알고리즘 일수록 배열 변수를 활용하게 되는데, 이 배열 변수들은 메모리로 구현하여 하드웨어 용량을 절약 한다. 하지만 다수의 값을 동시에 불러오지 못하는 메모리는 병렬처리를 저해하는 요소가 될 것이다.

- 파이프라인(pipeline): 실행문 사이의 의존 관계가 있는 경우 파이프라인 구조를 취하여 클럭당 처리량(throughput)을 증대 시킨다. 한 클럭당 한개 데이터를 처리할 수 있을 때 최적의 성능을 보장할 수 있겠으나 항상 이를 만족하지 못하는 경우 데이터 흐름에 병목이 생겨 정체가 일어난다. HLS에 파이프라인 지시를 주는 위치에 따라 레이턴시와 인터벌 클럭수가 다른 것은 병렬 구조의 차이 때문이다.

예제는 3x3 크기의 행렬 곱셈기(matrix multiplier)다. 두 행렬은 함수 외부에서 2차원 배열로 주어지며 행렬곱은 2차원 배열로 출력된다. 입력과 출력의 2차원 배열이 RAM 메모리에 저장되었다고 하자. 함수 matrixmul()의 내용은 행렬 곱셈을 수행하는 3중 반복문으로 구성되었다.

[맨위로]

-----------------------------------------------------------------------------------------------------

단계 1. 병렬처리가 억제된 합성(최소 하드웨어) 

HLS의 PIPELINE 지시자는 반복구문에서 변수들 사이의 의존성을 따져 병렬성을 파악하고 의존성이 있을 경우 파이프라인 구조를 만들어낸다. 이번 단계는 최소 하드웨워 자원을 사용하는 구조를 살펴보기 위해 행렬 곱셈기 함수에 PIPELINE을 억제 시키는 지시를 주고(PIPELINE off) 합성해 보자. 아울러 HLS가 다중 반복문을 어떻게 처리 하는지 스케쥴 뷰어를 통해 확인해 본다. 

PIPELINE이 억제되어 합성되었으므로 3중 반복문이 그대로 존재한다. 각 반복문 별 레이턴시 계산해 보면 아래와 같다.

Product 라벨이 붙여진 가장 안쪽의 k-반복문 내의 실행문이 3회 반복(trip count)된다. 반복되는 실행문이 1개에 불과하나 복잡한 구성을 하고 있다. 메모리 a와 b에서 읽기, 그리고 res에 쓰기가 있으며 곱셈과 누적을 수행한다. 메모리에 접근하려면 2 클럭이 소요되는데 읽기 혹은 쓰기 전에 주소가 선행되어야 하기 때문이다. 1개의 실행문이 1클럭내에 실행될 수 없다. 합성된 하드웨어의 반복 레이턴시(iteration latency)가 7이며 3회 반복(trip)하므로 Product 라벨의 레이턴시는 15다.

Col 라벨 역시 3번 반복한다. 하위 Product 의 레이턴시 15에 반복의 시작과 끝을 확인하는 상태가 각각 추가되어 17이다. 따라서 Col의 레이턴시는 51이다.

최상위 Row 반복의 경우 한번 진행으로 끝나므로 재시작할 필요가 없이 종료 조건만 확인한다. 따라서 하위 Col 반복을 3회 진행하고 종료 확인을 목적으로 1개 상태(클럭)가 추가 되어 161 클럭의 레이턴시를 갖는다.

실제 HLS를 통해 수행된 스케쥴은 다음과 같다. k-반복내의 실행문에 병렬성이 있으나 병렬구조는 억제되었다. k와 j-반복은 재반복 되고 i-반복은 한 회로 끝나는스케쥴을 볼 수 있다.

RTL/HDL-SystemC Co-Simulation

[맨위로]

-----------------------------------------------------------------------------------------------------

단계 2. 최하위 반복에 파이프라인 지시

PIPELINE이 억제되어 합성되면 실행문에 병렬성이 있더라도 병렬구조로 만들어 내지 않는다. 비록 전체 병렬 구조가 배제되어 더라도 k-반복 내에 파이프라인 구조가 가능하다.

k-반복의 스케쥴 개념도는 아래와 같다. 입력 a와 b가 각각 별도의 메모리 블럭에 구현되어 있어서 동시 읽기가 가능하다. 단계1에서는 파이프라인을 허용하지 않았으므로 반복 인터벌 6을 k-반복에서 3회, j 반복에서 3회, i 반복을 3회하여 총 레이턴시가 162가 된다. 

k-반복에 파이프라인을 허용한 하드웨어의 경우 ii=1이 가능하므로 인터벌 1을 가지고 k, i, j를 반복하여 레이턴시는 27이다.

스케쥴 뷰어로 확인해 보자.

만일 k-반복을 병렬처리 구조로 바꿀 경우 복수의 a 와 b를 동시에 읽어오는 상황이 생길 수 있다. 제한된 입출력 포트를 가진 RAM 메모리 자원은 동시에 다수 데이터를 읽고 쓰기가 불가능하므로 이런 병렬처리 요구가 불가하다. 따라서 반복을 시작하기 전에 순차적으로 RAM 접근을 진행해게 되어 ii가 1 이상을 넘는 바이얼레이션이 일어난다. 이를 제한된 자원으로 인한 ii-바이얼레이션(limited resource ii-violation) 이라 한다. 이에 대해서 다음 단계에서 다룬다.

RTL/HDL-SystemC CoSimulation 으로 확인해보면 다음과 같다. 파이프라인이 작동 되는 것을 알 수 있다.
[맨위로]

----------------------------------------------------------------------------------------------------

단계3. 상위 반복에 파이프라인 지시

3중 반복 구문에서 j-반복에 PIPELINE 지시하면 하부에 놓인 k-반복은 병렬 구조로 풀어낸다.
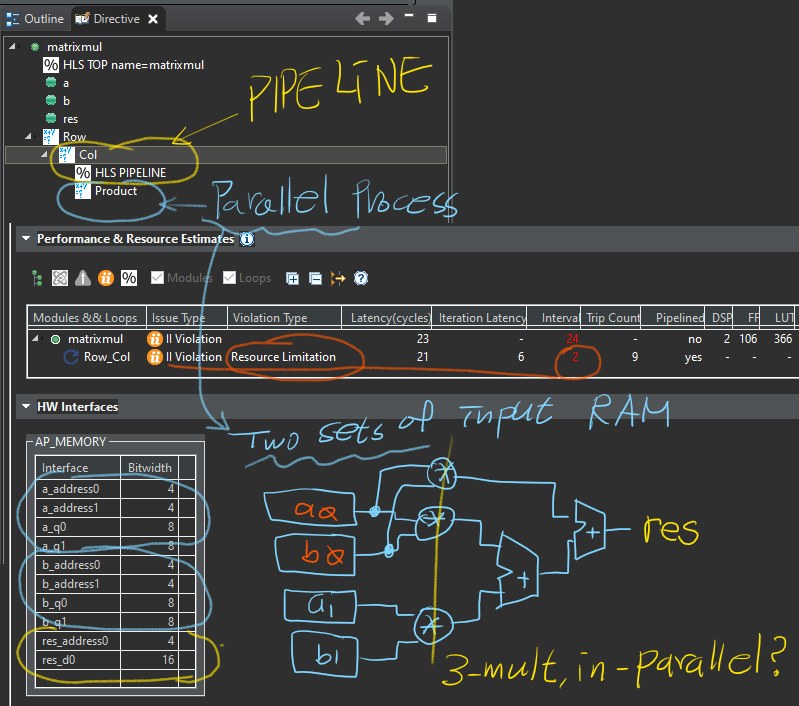
합성된 연사자들을 보면 3개의 곱셈기를 동원해 병렬 구조를 구성하고 있으나 RAM 메모리에 저장된 입력을 동시에 읽어올 수 없는 문제가 발생한다. 입력 a[]와 b[]는 병렬구조에 대응하기 위해 복제된 2쌍의 RAM에서 공급되는 구조다.

하지만 2쌍의 RAM으로 병렬구조의 곱셈기에 3-입력이 동시에 제공될 수 없어서 나누어 읽어와야 하므로 j- 반복을 시작하기 전에 두번째 a 값을 읽기위해 한 클럭을 더 소모하여 ii=2가 되어 바이얼레이션을 일으킨다.

PIPELINE 구조는 한 클럭 당 한개의 데이터 처리가 원칙이다. 반복을 시작하기 전 준비에 1 클럭 이상이 필요하면 ii 바이얼레이션이 발생한다. 바이얼레이션은 합성 실패가 아니다. 규칙에서 벗어났다는 의미다. 타이밍 바이얼레이션은 반드시 보완되어야 하지만 ii 바이얼레이션은 채택하기 여부에 달렸다.

RTL/HDL-SystemC CoSimulation

 [맨위로]

-----------------------------------------------------------------------------------------------------

단계 4. 배열 재정렬(ARRAY_RESHAPE)

두 쌍의 메모리를 가지고 최하위 k- 반복에 병렬 구조를 구성했더라도 RAM의 동시 읽기가 불가하여 파이프라인 규칙을 따르는 것이 불가했다. 그렇다면 ii=2의 원인이 됐던 입력 배열 변수 a[] 를 병렬로 펼쳐놓자. 2차원 배열을 모두 펼치면 9개(MAT_A_ROWS*MAT_A_COLS) 입력이 될 것이다. 한번에 3 입력이 필요하므로 ARRAY_PARTITION=complete 대신 ARRAY_RESHPE 지시자를 적용한다. 배열 입력 a[]

스케쥴 뷰어, ii=1

RTL/HDL-SystemC CoSimulation

Row와 Col 라벨이 붙은 두 반복 문이 결합되었다. 합성보고에 나온 대로 반복 레이턴시(iteration latency)는 6, ii=1의 파이프라인이 9번 진행(trip count) 되어 함수의 동작이 종결됨을 알 수 있다.

배열 입력 a[]와 b[] 그리고 출력 res[]의 주소가 직렬(stream)이다. 입출력 인터페이스를 메모리 대신 FIFO 가 가능해 보인다. 시스템 설계에서 모듈간 인터페이스로 메모리 모다 FIFO 채널을 선호한다. 메모리의 경우 주소 생성과 읽기/쓰기 제어를 위해 클럭을 소모할 뿐 더러 데이터 패스 지연이 긴 편이다. 무었보다 FIFO 인터페이스 채널은 데이터 발생 갯수에 동기를 맞춰야 하는 부담이 적다. 위 예제에서 봤듯이 연산을 모두 끝내기 까지 a[]의 데이터 요구 횟수는 3번인 반면 b[] 는 9회에 이른다. 만일 FIFO 였다면 주소 생성에 번거로 움을 덜 수 있다. 제어 FSM의 상태수도 단순해 지고 그만큼 소요되는 하드웨어도 준다.

[맨위로]

----------------------------------------------------------------------------------------------------

단계 5. FIFO 인터페이스

입출력 인수 a, b 그리고 res에 FIFO 인터페이스 지시(INTERFACE=ap_fifo)를 주고 합성했다. 합성 결과 보고를 살펴보니 기대하는 효과를 얻지 못했고 ii 바이얼레이션을 냈다.

HLS 경고(Warning)를 살펴보자. 바이얼레이션은 실패(fail)가 아니므로 경고에 포함되어 있다.

WARNING: [HLS 200-880] The II Violation in module 'matrixmul' (loop 'Row_Col'): Unable to enforce a carried dependence constraint (II = 1, distance = 1, offset = 1) between fifo write operation ('res_write_ln65', matrixmul.cpp:65) on port 'res' (matrixmul.cpp:65) and fifo write operation ('res_write_ln61', matrixmul.cpp:61) on port 'res' (matrixmul.cpp:61).

소스 코드의 61번 줄과 65번 줄의 fifo 쓰기를 II=1로 불가함.

WARNING: [HLS 214-142] Implementing stream: may cause mismatch if read and write accesses are not in sequential order on port 'res' (matrixmul.cpp:54:0)

WARNING: [HLS 214-142] Implementing stream: may cause mismatch if read and write accesses are not in sequential order on port 'b' (matrixmul.cpp:54:0) 

입력 b와 출력 res의 fifo 채널 인터페이스에 접근이 순차적이지 않음.(FIFO는 RAM 처럼 무작위 주소지정 할 수 없다.)

WARNING: [HLS 214-237] The INTERFACE pragma actions in object field. If on struct field, disaggregate pragma is required;  If on array element, array_partition pragma is required. If no, this interface pragma will be viewed as invalid and ignored. In function 'matrixmul(char (*) [3], char (*) [3], short (*) [3])' (matrixmul.cpp:54:0)  matrixmul_prj:

WARNING: [HLS 214-281] Estimating pipelined loop 'Col' (matrixmul.cpp:59:12) in function 'matrixmul' with estimated II increased from II=1 to II=2 because of limited port on variable 'res' (matrixmul.cpp:59:12)   matrixmul_prj:

출력 포트 res 에 입출력의 동시 요구에 제한이 있으므로 ii=1 에서 ii=2 로 변경

WARNING: [HLS 207-5542] the expression for 'port' option is invalid, top argument that is ap_fifo/axis port may require the 'volatile' qualifier to prevent the compiler from altering array accesses and/or modifying the desired streaming order:

[맨위로]

----------------------------------------------------------------------------------------------------

단계 6. 함수 단위로 PIPLINE 지시

반복문 마다 세분하여 합성 지시를 주어 최적의 결과를 얻어내려면 상당한 노력이 든다. 때로는 함수 전체에 합성 지시를 내릴 수도 있다.

합성 결과표를 근거로 내부 구조를 추정해 보면 다음과 같다. k- 반복을 3개의 곱셈을 갖는 병렬 파이프라인 구조로 풀어내기 위해 입력 인수 a[]와 b[] 그리고 출력 res[]가 모두 2중 RAM 으로 구현 했다. 2중 i-반복(Row)과 j-반복(Col)은 9개의 3입력 병렬 곱셈기 구조로 펼쳐 놓은(flatten) 구조다.

스케쥴 뷰어를 보면 i, j, k 반복이 아예 없이  3중 반복문이 한데 뭉친 병렬처리 파이프라인 구조다. 클럭 성능을 최대한 끌어올리고 있으나 하드웨어 사용량이 매우 높다. HLS의 최우선 목표는 클럭 성능을 높이는 것임을 알 수 있다.

RTL/HDL-SystemC CoSimulation

RAM 메모리에서 한번씩 읽어들인 입력인수를 매우 영리하게 사용하여 3x3 행렬에 필요한 27번의 곱셈을 수행한다. 인수 a[] 와 b[]를 읽어들이는 순서(주소)에 주목해 보자. 그리고 한번씩 읽어들인 인수를 쉬프트 시켜 3병렬 곱셈을 9회 반복하는 연산을 10 클럭(레이턴시는 11)만에 완료하고 있다.


외부에서 제공되는 인수를 반복적으로 다시 읽지 않는 구조는 하드웨어의 모듈(라이브러리)화 측면에서도 매우 중요하다. 기능을 완료하기 까지 입출력 횟수를 줄여 자체 레이턴시를 줄일 뿐만 아니라 외부 모듈과의 의존성을 낮출 수 있기 때문이다. 시스템 설계에서 FIFO 채널 인터페이스를 추구하는 이유 이기도 하다.

그나저나 C의 반복문에서 병렬 구조를 끌어 낼 뿐만 아니라 입출력 인터페이스까지 고려해 스케쥴 까지 짜는 HLS의 최적화의 능력은 대단하다.

[맨위로]

-----------------------------------------------------------------------------------------------------

실습 2: 소스코드 변경

시스템에는 다양한 작동 모듈이 집적된다. 모듈간 입출력 데이터의 생성과 소모율이 다를 수 밖에 없다. 시스템의 통신을 관장하는 전역 컨트롤러(또는 스케줄러)는 매우 정교해야 한다. 구성이 다양할 수록 스케쥴러의 복잡성이 높아지고 집적(integration)하는 과정에서 하위 모듈의 변경 교체에 대응하기도 어렵다. 이럴 때 선택할 수 있는 방법이 다수 마스터를 허용(버스 스케줄러 scheduler, 아비터 arbiter 를 가진)하는 시스템 버스의 채택이다. 전송전 버스점유 허용 절차에 클럭 소모가 많아 소규모 입출력 혹은 클럭단위 입출력 모듈의 경우 불리하다. 버스트(스트림) 트랜잭션에 유리하다.

전역 스케줄러 없이 하위 모듈끼리 알아서 통신을 처리하는 방법으로 FIFO 인터페이스 채널이 있다. 모듈간 복잡한 핸드쉐이크가 필요 없다. 모듈은 통신 채널에 빈공간이 있는지, 읽어올 데이터가 쌓였는지 확인할 뿐 상대 모듈이 언재 통신할 준비가 되었는지 감시할 필요 없다. 시스템 관리자는 그저 구성 모들의 성능(쓰루풋, throughput)을 다그칠 뿐이다.

3x3 행렬 곱셈기를 ii=1인 파이프라인 구조에 입출력에 FIFO 인터페이스 채널로 합성해 보자. 앞서 단계 5에서 입출력 포트에 INTERFACE=ap_fifo 지시를 주었으나 성공하지 못했다. 함수 내 중복 반복문에서 포트를 무작위(random) 주소 접근으로 읽은 탓이다. 게다가 반복적으로 다시 읽기까지 하는 구조로는 fifo 인터페이스는 불가하므로 소스를 수정해 주기로 한다. 입출력을 미리 한번 읽어두는 방식으로 바꿔 놓고 k- 반복의 누산(accumulation)을 출력 포트에 누산시키지 않고 내부 임시 변수를 쓰도록 한다. FIFO 인터페이스의 요건에 맞도로 수정된 C 소스코드는 아래와 같다.

합성 결과 보고를 보면 인터페이스에 문제가 있어 보인다. 입력 b[] 와 출력 res[]는 FIFO 인테페이스로 합성되었으나 입력 a[]는 여전히 메모리 인터페이스다.

생성된 RTL/HDL을 가지고 SystemC CoSimulation 을 해보면 a[]의 주소도 순차적이며 다시 읽기도 없다. 메모리 인터페이스에서 FIFO로 변경되지 않은 이유는 알 수 없다. ARRAY_RESHAPE에 dim=2 로 한 것이 원인 것으로 보인다.

[맨위로]

---------------------------------------------------------------------------------
고위 합성 튜토리얼(High-Level Synthesis Tutorial)
[목차][이전][다음]


2021년 10월 8일 금요일

6장. 설계 분석-II (Design Analysis-II)

6장. 설계 분석-II (Design Analysis-II)

개요
C 설계 검토 및 검증: 2차원 DCT(2-D Discrete Cosine Transform)
단계 1. 최초 합성
단계 2. 최상위 모듈에 파이프라인 지시(최고 클럭 성능)
단계 3. 최상위 모듈에 파이프라인 억제 지시(최소 하드웨어 자원)
단계 4. 반복문 최적화: 파이프라인 지시 및 메모리 분할
단계 5. 병렬성 강화 최적화 (DATAFLOW)
단계 6. 계층구조 최적화 (INLINE)

-----------------------------------------------------------------------------------------------------

단계 3. 최상위 모듈에 파이프라인 억제 지시(최소 하드웨어 자원) [소스 다운로드]

C 설계 함수 dct()를 구성하는 하위함수들에 기본으로 들어갔던 파이프라인 지시를 억제 시켜 놓고 합성해 보자. 하드웨어를 최소로 쓰는 구조가 될 것이다.

설계 전반에 걸쳐 2중 for 반복문이 있고 안쪽 반복(inner Loop)에서 자원 공유된 탓에 소요된 하드웨어 자원의 양이 최소화 되었으나 인터벌이 너무 커서 고속처리를 원했던 목적에 한참 뒤진다.

시뮬레이션으로 확인 해보면 한개 입출력 읽기와 쓰기에 3클럭을 쓰고있다. 특히 출력 쓰기 타이밍을 보면 8번째 마다 쓰기에 한 클럭이 더 소요되는데 반복문 탈출 검사가 필요 했기 때문이다. 확실히 파이프라인 처리는 전혀 하지 않고 있음을 알 수 있다.

굳이 스케쥴 뷰어(schedule viewer)를 보면서 확인 할 필요는 없겠지만 '실습'이니 만큼 반복문이 어떻게 합성되는지 보기나 하자. 메모리에 출력 데이터를 써넣는 부분의 스케쥴이다. 원 소스에 레이블을 붙여 놓으면 분석할 때 도움이 된다. 특히 반복문에 레이블이 붙이도록 하자.

스케쥴 표를 보고 있노라면 합성기가 상당히 잘 처리하고 있는 것을 볼 수 있다. 마치 C에서 변환된 어셈블리(assembly)어를 보는 느낌이다. 스케쥴 뷰어에서 녹색으로 표시된 화살표(green arc)은 되돌림 반복이다. 파이프라인 구조를 위해서 녹색 그래프를 없애야 한다. 스케쥴 표를 보면 역방향 그래프는 모두 2중 for 반복문에서 안쪽 반복에 걸려 있다.

-----------------------------------------------------------------------------------------------------

단계 4. 반복문 최적화: 파이프라인 지시 [소스 다운로드]

수많은 합성 지시를 줄 수 있다. 일일이 다 적용해보기도 좋지만 시간이 오래 걸릴 뿐더러 합성 지시가 기대와 정반대 결과를 내기도 한다. 따라서 지시를 주고 결과 분석 과정을 통해 최적의 합성 결과를 얻기 위해 전략적으로 접근해 보자. 이번 단계는 반복문에 파이프라인 합성 지시를 하고 그 결과를 분석해 보자. 반복문이 중첩되어 있다면 안쪽 반복문을 먼저 파리프라인 처리를 지시하는것이 일반적인 접근이다. 단계 1의 최초 합성은 dct()를 구성하는 하위 함수의 2중 반복 중 안쪽 반복에 모두 PIPELINE 을 적용하고 얻은 결과다.

4-1. 입출력 데이터 처리 함수 read_data()와 write_data()에 PIPELINE 지시

다중반복(nested loop)이 있는 경우 가장 안쪽 반복에 PIPELINE 을 적용하는 전략이 항상 좋은 결과를 낳는 것은 아니다. 먼저 데이터 입력 부분부터 병렬성을 높여 보기로 하자. read_data()는 dct() 전과정에서 파이프라인의 시작점이기도 하다.

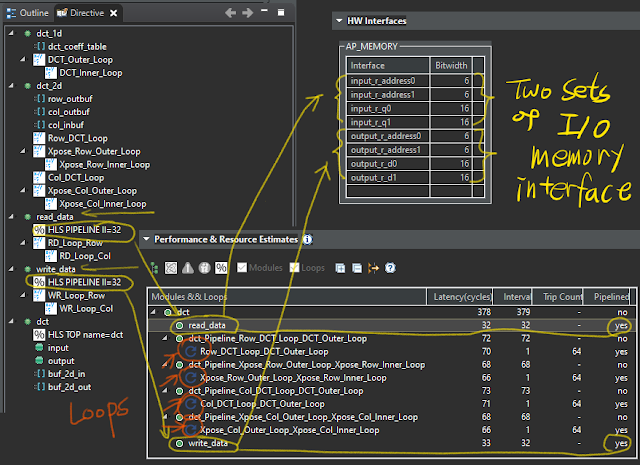
read_data() 와 write_data()의 외측 반복에 준 PIPELINE 지시자가 효과가 있었다. 레이블 앞에 있던 반복 표시(둥근 화살표)가 모두 사라졌고 부분 레이턴시도 반으로 줄었다. 병렬성을 높이려고 입출력 메모리 인터페이스가 두쌍이 된 점에 유의하자.

4-2. 1차원 DCT dct_1d()에 PIPELINE 지시

가장 많은 연산과 반복이 포함된 함수는 1차원 DCT, dct_1d() 다. 특히 이 함수는 2차원 DCT 를 위해 8행에 대한 처리를 두번 실행되고 양쪽으로 2차원 메모리 트랜스포스를 두고 있다. 따라서 2차원 DCT 내에는 총 16번의 1차원 DCT가 실행 된다.

메모리 트랜스포스는 알고리즘의 특성상 앞의 1D-DCT 가 완료되기 전까지 시작할 수 없다. 단독으로 파이프라인 처리가 불가하다.

PIPELINE 지시를 dct_1d() 함수에 주는 위치에 따라 합성 결과가 달라진다. 병렬처리 구조 변경을 함수 내부에 제한하거나 연결된 외부 함수까지 영향을 미칠 수 있다. 클럭 성능이 향상되면 높은 병렬 성을 추구하는 구조가 되어 하드웨어 자원 사용량은 증가한다.

(1) dct_1d() 내의 외곽 반복 DCT_Outer_Loop에 PIPELINE 를 지시한 경우:

dct_1d()는 레이턴시 16을 갖는 파이프라인 처리되지만 8행 반복 Row_DCT_Loop 와 Col_DCT_Loop 가 파이프라인에서 제외되어 전체 레이턴시 552로 성능이 오히려 악화됨. 파이프라인에서 제외된 반복에서 사용하는 배열변수는 레지스터 메모리 대신 BRAM을 활용 한다.

(2) dct_1d() 전체에 PIPELINE 를 지시한 경우:

dct_1d()가 레이턴시 16을 갖는 파이프라인, 이 함수와 연관된 8행 반복 Row_DCT_Loop 와 Col_DCT_Loop 가 파이프라인 구조를 갖진 못했으나 dct_1d()와 결합되어 전체 레이턴시 176으로 향상됨. 하드웨어 자원 사용량 3배가량 대폭 증가함. 모든 배열 변수들이 레지스터 변수로 구현 되었기 때문에 BRAM 사용은 없다. 

(3) dct_1d()함수와 외곽 반복 DCT_Outer_Loop에 PIPELINE 을 동시에 지시한 경우:

dct_1d()의 내부 최적화와 외부 8행 반복을 분리 합성 함. dct_1d()의 내부 레이턴시 7, 외부 8행 반복 Row_DCT_Loop 와 Col_DCT_Loop 가 레이턴시 1로 8번 반복함. 전체 레이턴시 265. 레이턴시와 하드웨어 사용량의 타협이 이뤄짐. 배열 변수 일부가 BRAM으로 구현 되었다.

4-3. 메모리 트랜스포스 반복에 PIPELINE 지시

dct_1d()에 준 PIPELINE 이 클럭 성능 면에서 효과가 있었으므로 이를 선택하고 양쪽에 끼고있는 트랜스포스의 외곽 반복에 같은 합성 지시를 주었지만 좋은 결과를 얻지 못했다. 합성 결과를 보면 전체 레이턴시가 176에서 272로 올라 갔고 하드웨어 사용량은 오히려 증가했다. 앞서 이뤄진 1차원 DCT의 8행 반복 이후 트랜스포스 메모리 사이에 병목이 있다는 바이얼레이션이다.

메모리 병목을 해결하기 위해 dct_1d()와 트랜스포스 사이의 2차원 배열을 분할(array partition)해 주어 바이얼레이션이 해결했다.

최종적으로 얻은 dct()의 레이턴시가 138 목표치 130보다 조금 크다. 최초 합성(단계1)에 비해 레이턴시는 430에서 138로 줄었고 하드웨어 사용량은 6배가량 증가 했다.

고성능 합성(단계2)의 레이턴시 69에 비해 두배지만 하드웨어 사용량은 1/4 수준이다. 클럭 성능과 하드웨어 사용량 사이의 적당한 타협이다.

각 단계에서 사용된 배열 변수들의 구현 방식에 주목해야 한다. 파이프라인 처리가 강화 될 수록 대규모 배열 변수에 BRAM 대신 LUT 내의 플립플롭으로 구현되어 하드웨어 사용량이 급격히 증가한다. FPGA 처럼 미리 배치된 경우라면 어짜피 있는 자원 그대로 활용할 테지만 ASIC 이라면 심각히 고려되어야 한다. HLS 합성 옵션(지시자)에 따라 레이턴시와 하드웨어 사용량 변화폭이 상당 함에도 FPGA에서 이를 검토대상에 넣고 받아들이는 이유는 미리 배치된 반도체 부품이기 때문이다. ASIC 을 목표로 한다면 저장소에 RAM/ROM을 활용 할지 플립플롭으로 구현할지 명확히 해주므로 옵션 변화에 따른 성능차는 작다. 대용량 FPGA를 목표로 하는 HLS의 경우 하드웨어 자원 활용을 최대한 허용하므로 상대적으로 합성이 수월한 편이라고 할 것이다.

-----------------------------------------------------------------------------------------------------

단계 5. 병렬성 강화 최적화(DATAFLOW) [소스 다운로드]

앞선 단계까지 dct_2d()를 구성하는 하위 함수들에 대하여 최적의 PIPELINE 합성을 찾았다. 최종적으로 얻은 dct()의 구성은 read_data(), write_data() 그리고 dct_2d() 다. 세 하부 블럭들을 묶어 병렬 실행성(parallelism)을 찾아 보기 위해 DATAFLOW 지시자를 적용해 보자.

인터벌이 139에서 72로 줄었다. dct()를 구성하는 세 하위 모듈들의 인터벌을 모두 더한 것보다 적다. 전체 인터벌과 가장 많은 클럭을 쓰는 dct_2d 모듈의 인터벌이 같다. 세 모듈들이 병렬로 실행되게 되었다는 뜻이다.

만일 dct_1d의 출력 버퍼와 트랜스포스 메모리를 합쳤더라면 메모리 자원을 절약하고 트랜스포스 동작이 아예 없어져서 소요 클럭도 줄일 수 있었을 것이다. 하지만 한 메모리에 대한 열 쓰기(column read)와 행 읽기(row write)를 동시에 하기는 불가하므로 하위 구성 모듈간 병렬 처리는 없다. 따라서 병렬처리로 얻은 인터벌 72 대신 32+71+32=135 에서 두번의 트랜스포스 처리에 소요된 16(=8+8, 외곽 반복 횟수)을 뺀 인터벌은 119 다.

하위 모듈 병렬처리를 RTL/HDL-SystemC Co-Simulation으로 확인해 보자. 최초 레이턴시 137 클럭 이후 read_data와 write_data 모듈이 dct_2d와 병렬 처리되면서 인터벌이 72로 반복된다. 2차원 데이터는 입력 버퍼 buf_2d_in[][]와 출력 버퍼 buf_2d_out[][] 그리고 트랜스포스 col_in_buf[][]의 3단계에서 저장된다. 따라서 병렬 처리 후 출력 데이타는 읽기와 3단 차이를 두고 반복된다는 점도 유의하자. 최초 레이턴시 입력에 대한 출력 후 인터벌 출력 사이의 출력은 무효한 출력이 있다.

입출력 메모리 RAM의 주소도 가지런 해졌다.


-----------------------------------------------------------------------------------------------------

단계 6. 계층구조 최적화(INLINE)

계층 구조화(hierarchy)는 소프트웨어 개발에서 함수를 라이브러리화 하여 재사용성을 높여 코드 메모리의 절약을 위한 기법이 될 수 있지만 하드웨어에서는 의미없다. 인터벌을 가장 많이 차지하는 dct_2d() 를 dct()의 하위 모듈에서 끌어 올려 평탄화 시켜 보자. 하위 모듈을 반복적으로 호출 하느라 소요되는 클럭을 줄일 수 있다.

주: 인터벌이 32로 줄긴 했으나 이는 어디까지나 병렬 처리하는 하위 모듈 중 가장 긴 인터벌을 차지하는 숫자일 뿐, 실용성 없는 숫자다. 32 클럭 내에 하위 모듈들의 병렬 실행 스케쥴을 잡기도 어려울 뿐만 아니라 입출력 메모리를 읽기에도 빠듣하다. 32클럭마다 계속 읽어온다면 외부에서 입출력 데이터를 저장해줄 틈이 없다. 이럴때 메모리 입출력 대신 FIFO를 쓰는 것이다.

---------------------------------------------------------------------------------
고위 합성 튜토리얼(High-Level Synthesis Tutorial)
[목차][이전][다음]

2021년 10월 5일 화요일

6장. 설계 분석-I (Design Analysis-I)

6장. 설계 분석-I (Design Analysis-I)

개요
C 설계 검토 및 검증: 2차원 DCT(2-D Discrete Cosine Transform)
단계 1. 최초 합성
단계 2. 최상위 모듈에 파이프라인 지시(최고 클럭 성능)
단계 3. 최상위 모듈에 파이프라인 억제 지시(최소 하드웨어 자원)
단계 4. 반복문 최적화: 파이프라인 지시 및 메모리 분할
단계 5. 병렬성 강화 최적화 (DATAFLOW)
단계 6. 계층구조 최적화 (INLINE)

-----------------------------------------------------------------------------------------------------

개요

C/C++ 설계로부터 고위합성(HLS)으로 RTL/HDL 구현의 수순의 일반적인 과정은 다음과 같다.

(1) 알고리즘을 기술한 C 언어 설계가 준비(검증) 되었다.
(2) C/C++ 설계를 합성한다.
(3) 최초 합성 결과 보고서를 보고 성능요구에 부합 하는지 검토한다.

최초 합성은 별도의 지시 없이 합성기의 자체 판단으로 합성된 것이다. 소프트웨어 개발시 컴파일러의 기본 옵션으로도 만족할 만한 결과를 얻기 쉽다. 작동개념이 전혀다른 하드웨어 합성의 경우 옵션(지시자)에 따라 매우 상이한 성능결과를 낳는다. 기본 옵션으로 요구 성능(소요 클럭수와 자원 사용량)을 맞추는 경우는 드물다.

(4) 요구 성능에 부합할 때 까지 적절한 최적화 지시자를 주고 합성과 검토를 반복한다.

가급적 원 설계(source code)를 손대지 않아야 한다. 온갖 합성 지시의 적용에도 요구성능을 맞추지 못한다면 별수 없이 설계를 수정한다. 설계 알고리즘을 다 알지 못하더라도 기본적인 구조는 파악해야 적재적소에 최적의 합성지시자를 줄 수 있다.

-----------------------------------------------------------------------------------------------------

C 설계 검토 및 검증: 2차원 DCT(2-D Discrete Cosine Transform)

이번 실습에 사용할 예제는 2차원 이산 코사인 변환(DCT)이다. 자료형은 모두 16비트 정수로 꾸며져 있다. 코사인 변환 알고리즘의 기본 특성은 계수 행렬 곱하기 입력 벡터다. 곱셈과 누적이 반복되는 계산구조다. 1차원 8 샘플 DCT를 그림으로 표현하면 아래와 같다.

코사인 계수 행렬의 의미를 이해해 보자. y[0] 는 입력 샘플 x[i]에서 코사인 계수행렬 첫번째 열의 특징을 갖는 성분의 크기가 된다. 즉 상수성분이다. y[1]은 코사인 계수행렬 두번째 열의 특징을 갖는 성분의 크기다. 즉 주파수가 1인 성분이다. 이어서 y[6]은 코사인 계수행렬 여섯번째 열의 특징을 갖는 성분의 크기다. 즉 주파수가 3인 성분의 크기다. 결국 DCT 변환을 마치고 y[i]를 살펴보면 입력 샘플 x[i]에서 어떤 변화성분을 가지는지 분석해 준다. 이런 삼각함수 변환은 시계열 샘플에서 변화특성 성분(혹은 주파수)을 찾아주는 알고리즘이다.
계수 행렬식을 보면 대칭성을 가지고 있다. 부호만 다르고 같은 계수값을 곱하게 된다. 곱셈을 굳이 여러번 수행 할 필요가 없다. 앞서 곱한 값을 나중에 더하고 빼기만 다시 활용해서 곱셈의 횟수를 줄일 수 있다. 소위 고속 알고리즘이라고 하는 것이다. 예제로 사용할 C 설계 dct()는 고속 알고리즘을 적용한 것은 아니며 쌩짜 행렬 곱셈이다.


[참고]
[1] 이산 코사인 변환, 위키백과
[2] Discrete Cosine Transform, Wikipedia
[3] 8-tap Winograd DCT oprimised for F-CPU
[4] Spectral Decomposition of Two-Dimensional Atmospheric Fields on Limited-Area Domains Using the Discrete Cosine Transform (DCT)
[5] Design and Implementation of a High-Performance and Complexity-Effective VLIW DSP for Multimedia Applications
[6] 2D DCT

------------------------------

여담: DCT 계산에 대해 잘 모른다고 겁먹을 것 없다. 가끔 수학이 약하다며 설계를 걱정하는 경우를 보게 되는데 본분을 망각한 소리다. 우리는 DSP 알고리즘을 고안해 내는 수학자가 아니라 이용자들이란 점을 잊지말자. 알고리즘을 발견하고 증명해 준 수학자들에게 감사하며 이용을 잘하면 된다. 사실 DSP에 관한 수학을 원리부터 증명까지 해내며 사용하는 경우를 본적이 없다. 우리가 언재 논리식 간략화부터 따지며 디지털 설계를 했던가 말이다. 그것이 뭔지 잘 이해하고 활용할 줄 알면 되는 거다. 물론 행렬 곱셈이 뭔진 알거라 믿는다.

------------------------------

하드웨어 구현 시 수학적 계산구조 외에 검토될 사항은 입출력 자료가 공급되는 방식이다. 예제의 함수 dct(input[N], output[N]) 경우 8x8 크기의 2차원 입력 벡터가 직렬로 공급된다. 따라서 한번에 입력되는 벡터(입력 데이터) 크기는 64다. 2D-DCT가 완료되면 2차원 데이터가 직렬로 출력된다.

2차원 입력 데이터에 대한 DCT는 dct_2d() 가 두번 실행되는데 그 사이에 행렬 트랜스포스(transpose)가 있다. 그리고 dct_2d() 내에 8번의 1차원 DCT 함수 dct_1d() 가 수행된다. 따라서 2D-DCT의 완료를 위해 총 16번의 1D-DCT가 수행된다.

2차원 DCT의 가장 핵심인 1D-DCT 함수 dct_1d()의 C 코드는 다음과 같다.

8회의 16비트 곱셈을 누적하면 최대 (32비트+4비트)까지 값을 갖는다. DESCALE()은 연속적인 곱셈과 누적으로 인한 오버플로우를 방지하기 위해 하위 비트를 잘라내는 매크로다.

2중 반복문이 포함된 dct_1d()의 하드웨어 합성 옵션

1차원 8x8 DCT의 알고리즘을 단순화 시켜보면 다음과 같다. 안쪽 반복문에 src[n] 와 C[k][n]을 곱해 dst[k]에 저장한다. 할당문 오른편과 왼편의 의존 관계를 따져 보면 k 반복은 양쪽에 동시성을 가진다. 이에 반해 n 반복은 할당문 왼편 내에서 누적 된다. 반복 누적은 파이프라인 으로 처리 된다.

파이프라인을 하지 않았을 경우 다음과 같은 하드웨어 구조 가졌을 것이다. 최소의 하드웨어 자원을 사용하지만 소요 클럭은 매우 많은 클럭을 소모한다.

안쪽 반복문에 파이프라인 합성하면 다음과 갖은 구조를 가지게 된다. 하드웨어 사용량은 급격히 늘어나지만 소요 클럭 수가 감소하여 고성능을 얻을 수 있다.

반복문 내 할당문 양쪽에 색인의 의존성이 없기 때문에 바깥쪽 반복문은 동시 처리가 가능하다. 클럭 소요가 매우 감소하지만 하드웨어 사용량은 급격히 증가한다. 게다가 64개의 src[64]도 동시에 준비되어야 한다. 동시 병렬 처리를 하려면 입출력도 그에 맞춰 준비되어야 한다. 

C 설계 검증

-----------------------------------------------------------------------------------------------------

단계 1. 최초 합성 [소스 다운로드]

합성 목표로 지연 타이밍을 10ns 이내, 인터벌을 130 클럭 이내로 잡았다. 8x8 2D-DCT 알고리즘의 특징은 직렬로 입력되는 64개의 데이터를 메모리에서 읽고 쓰면서 동작한다. 메모리 주소생성에 1클럭, 읽기 및 쓰기에 1클럭을 잡더라도 최소 128클럭이 소요되는 알고리즘이다. 먼저 별도의 합성 지시 없이 합성해 본다.

지연 타이밍은 목표를 맞췄지만 인터벌은 430으로 목표치 130을 한참 넘었다. 다행히 기본 옵션으로도 DCT를 구성하는 모든 하위 함수들이 파이프라인 구조로 합성된 것으로 봐서 DCT 알고리즘이 기본적으로 고성능 파이프라인 구조로 합성 하는데 무리가 없어 보인다. 각 하위 함수들이 차지하는 인터벌 수도 골고루 분포하고 있다. 그도 그럴 것이 모든 하위 함수들의 특징이 2중 배열로 메모리 읽기와 쓰기를 반복 하고 있기 때문이다.

C의 반복문을 하드웨어로 변환할때 변수들 사이의 의존성을 따져 병렬성을 찾고 의존성을 갖는 경우 파이프라인 구조를 갖도록 합성한다. 다중 반복문이 포함된 경우 가장 안쪽의 반복을 먼저 파이프라인 처리한다. 합성 보고서를 보면 2중의 for 반복 중 안쪽 반복 문이 파이프라인 구조로 펼쳐졌고 바깥쪽 반복을 수행하도록 합성되었음을 알 수 있다.

최초 합성으로 얻은 RTL/HDL의 SystemC 테스트 벤치 Co-Simulation

레이턴시와 인터벌이 각각 429와 430이다. 입출력 메모리 주소가 직렬 순차적이다. 만일 레이턴시를 64 까지 줄일 수 있다면 전체 파이프라인 구조가 가능할지도 모른다.

---------------------------------------------------------------------

스케쥴 뷰어(Schedule Viewer)

스케쥴 뷰어(Schedule Viewer)는 HLS 가 C/C++ 설계를 RTL로 합성하면서 클럭 진행을 어떻게 했는지 보여준다. 아울러 합성 중 메모리 객체(RAM과 레지스터)들 사이의 의존관계 처리 그래프도 보여 준다. 합성기는 객체들 사이의 의존관계를 따져서 하드웨어의 병렬 혹은 순차(파이프라인) 구조를 결정하게 된다. 스케쥴 뷰어를 보면 dct()의 하위 함수들이 어떻게 실행 되었는지 알 수 있다. 최초 합성의 스케쥴을 보면 하위 함수들 내부에서 파이프라인 구조를 이루고 있으나 부분 모듈 사이의 병렬성을 전혀 고려되지 않았다.

dct()의 하위 함수 중 1차원 DCT를 처리하는 dct_1d()의 내부 스케쥴을 보면 다음과 같다. 아래 그림은 dct_1d()의 스케쥴 중 일부를 보여준다. DCT_Inner_Loop의 for-반복문에 8번의 곱셈이 있는 것을 4개씩 펼쳐서 병렬처리 하고 1클럭 간격으로 파이프라인 처리하는 구조로 합성 되었음을 보여준다. 스케쥴 뷰어는 해당 합성 그래프에 해당하는 C 코드의 대응을 보여준다(Goto Source). 설계분석에 매우 유용한 기능이다.

-----------------------------------------------------------------------------------------------------

단계 2. 최상위 모듈에 파이프라인 지시(최고 클럭 성능) [소스 다운로드]

INLINE 은 하위 함수(모듈)을 구분하지 않고 평평하게(flattening) 모으는 지시자다. 최상위 모듈에 PIPELINE을 지시하면 INLINE 하지 않더라도 하위 함수들을 모두 한데 모아서 파이프라인 구조로 합성한다. 하위 함수들이 한데 펼쳐 있으므로 합성기는 설계 전역에 걸쳐 병렬 및 파이프라인 구조를 찾아낸다.

합성 결과 보고를 보면 비록 II(Interval Initiation) 바이얼레이션이 있으나 인터벌이 겨우 32로 엄청나게 줄었고 레이턴시는 69다. 메모리에서 64개 데이터의 읽기와 쓰기를 수행 하려면 메모리 주소가 선행되어야 하는 절차를 감안 하면 매우 적은 수의 인터벌이다. 좀더 최적화를 지시하면 완전 파이프라인 처리가 가능할까? 파이프라인에 집착하는 이유는 시계열 샘플을 지체 없이 처리해 낼 수 있는 구조이기 때문이다.

스케쥴 뷰어를 보면 레이턴시의 0번째 클럭에서 69번째 클럭 까지 전과정이 파이프라인 처리되고 있음을 보여준다. 되돌림이 없도록 반복문을 모두 펼친 병렬 구조를 하고 있으므로 자원 공유(resource sharing)가 없기 때문에 하드웨어의 규모가 엄청나게 늘어났다.

---------------------------------------------------------

배열 변수: 레지스터(Register) vs 메모리(Memory)

배열 변수를 구현하는 방법은 메모리 혹은 레지스터다. 변수를 레지스터(프립플롭, F/F)로 구현하면 매우 빠른 하드웨어 구조를 만들 수 있지만 소요되는 회로의 양이 너무나 늘어난다. 메모리는 밀집된 회로구성이 가능하기 때문에 반도체 면적 차지가 적으면서 대규모 저장소 구성이 가능하다. 하지만 주소지정 후 읽기 또는 쓰기 동작을 해야 하므로 추가 클럭이 든다. 더블어 주소 생성규칙을 짜야하기 때문에 다소 복잡한 계산이 들어간다. 물론 이 계산은 합성기가 알아서 해준다.

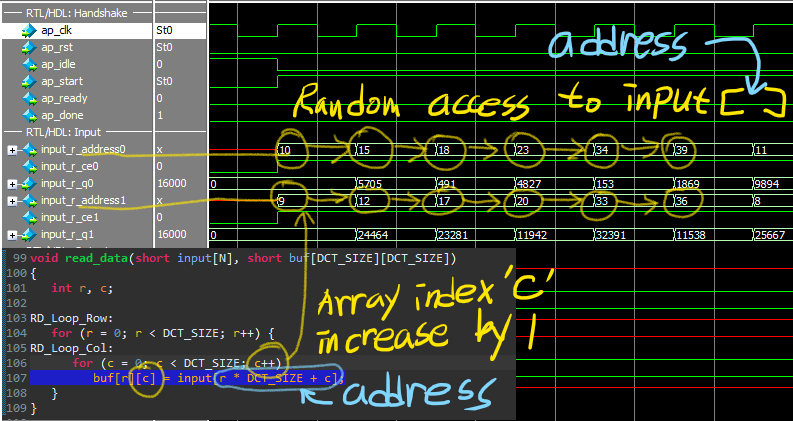
합성기는 프로그래밍 언어의 순차 반복문이더라도 읽고 쓰는 변수들 사이의 의존관계를 따져 병렬성을 찾아낸다. 따라서 하드웨어로 구현된 회로에서는 배열 변수의 주소가 마치 규칙성이 없어 보일 수 있다. 고위 합성된 dct()의 입출력에 메모리가 사용되었다. 이 메모리에서 읽거나 쓰는 순서(주소)가 무질서 한 듣 보이는데 이는 병렬 구조를 위해 계산된 주소다. 따라서 입출력 자료를 저장하는 메모리는 RAM(random access memory) 이어야 한다. 입출력에 저장소를 RAM 대신 FIFO 방식을 취하면 주소지정 단계가 없으므로 대용량이면서 빠른 하드웨어 구성이 가능 하다. 하지만 알고리즘마다 병렬성이 다르기 때문에 FIFO를 쓸 수 없는 경우에 해당한다.

------------------------------------------------------------

인터페이스에 두 세트의 메모리(RAM)를 둔 이유

DCT 알고리즘의 특성은 한 변수에서 두개의 데이터를 요구하는 두 연산의의 결과는 서로 의존 관계가 없다. 두 연산이 병렬성을 가진다고 한다. 반복문을 펼쳐 놓으면 동시에 실행 시켜도 좋다. 단, 입력 데이터 역시 동시에 준비 되어야 한다. 병렬성을 최대한 살리기 위해서 내용이 동일한 메모리를 두쌍을 두어 병렬 처리를 가능케 한다.

입력과 마찬가지 이유에서 함수의 출력에도 두 개의 메모리 인터페이스를 두고 있다. 입력의 경우 동일한 내용의 RAM을 두면 됐지만 출력은 두 내용을 합쳐 주어야 한다.

------------------------------------------------------------

Loop Pipeline Initiation Interval(II)

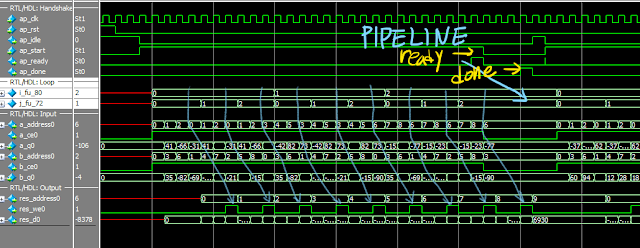
처음 입력이 주어지고 출력이 나오기 시작 할 때 까지 인터벌은 32, 동작이 완전히 종료할 때까지 레이턴시는 69다. 이 둘의 차이가 크다고 해서 문제 될 것은 없다. 다만 출력이 개시 되면서 새로운 시작이 가능할 때 파이프라인 처리의 장점이 있다. 2D-DCT 알고리즘의 경우 출력이 순차적으로 나오지 않기 때문에 출력이 나오기 시작하는 시점인 ap_ready에서 새로운 입력을 줄 수 없다. 모든 출력이 완료되는 ap_done 될 때까지 ap_start를 기다려야 한다. 이는 파이프라인 처리를 해치기 때문에 초기 인터벌 조건을 위배했다는 경고를 냈다. 입출력에 FIFO 인터페이스를 쓸 수 없었던 이유와 같다. 애써 많은 하드웨어 자원을 동원하여 고속의 구조(인터벌이 짧은)를 만들었지만 레이턴시가 그의 두배에 달한다면 낭비라 할 것이다.

파이프라인 처리를 목표로 했다면 합성하기 전부터 II 바이얼레이션을 미리 예측하고 원시 코드를 수정할 수 있어야 한다. 하지만 알고리즘의 개발단계에서 모든 병렬성을 따져가며 알고리즘을 기술하기는 쉽지 않다.

[참고]
[1] Loop Pipeline Initiation Interval Estimation Using LLVM

HLS 가 내는 II 바이얼레이션 메시지는 합성에 실패 했다는 뜻이 아니다. 파이프라인 처리 규칙을 위배 했다는 일종의 경고다. 이 사실을 인지 했으므로 합성 지시자에 PIPELINE II=32 라는 추가 옵션을 주면 바이얼레이션은 사라진다. 합성 보고서에서 빨간 경고는 없으면 좋은 것이다.

------------------------------------------------------------

하드웨어 사용이 과도하지만 고속의 합성 결과를 받아 들일 것인가?

반도체 성능은 하드웨어 규모와 클럭 소요량의 두가지 측면에서 따진다. FPGA는 이미 하드웨어가 모두 배치되어 생산된 반도체 부품이다. FPGA가 허용하는 용량에 설계가 들어간다면 클럭 소요량만을 따져 결정 할 수 있다. 어짜피 제조된 FPGA 용량을 굳이 남길 이유는 없다. FPGA가 계산 가속화(computing acceleration)를 목적으로 활용되는 경우 빠른 처리속도 위주의 결정을 한다. 더구나 필요에 따라 용도를 바꿀 수 있는 재구성 가능한(reconfigurable) FPGA를 HLS와 함께 활용 한다면 마치 소프트웨어를 실행 하는 CPU 처럼 사용될 수 있다. ASIC 제조전 검증용으로 많이 사용되는 대규모 FPGA는 고성능 계산기(high-performance computing machine)로도 여러 산업 분야에서 널리 활용되고 있다. 취약한 환경의 산업분야(우주항공 aerospace, 방산 defense, 의료 medical, 원격측정 telemetry 등)에서 고속 CPU는 클럭의 주기 간격이 너무 좁기 때문에 위험하다. 낮은 클럭 속도의 계산기이면서 고속 처리를 요구하는 경우 재구성 가능한 FPGA의 활용도는 높다. 

[0] FPGA Research
[1] South Pole Telescope Software Systems: Control, Monitoring, and Data Acquisition
[2] Accelerating Scientific Computations using FPGAs
[3] The Advantages of Embedded FPGA for Aerospace and Defense
[4] What are the applications of FPGA in the aerospace field

-----------------------------------------------------------

파이프라인 처리를 하려 했으나 입출력의 무작위 주소 툭성 때문에 어짜피 파이프라인 처리가 불가해졌다. 굳이 과도한 하드웨어를 써가며 파이프라인으로 합성할 이유가 없다. 클럭 소요 목표치인 130 클럭 이내로 줄여 과도한 하드웨어 사용을 줄이는 방안을 찾아보자.

---------------------------------------------------------------------------------
고위 합성 튜토리얼(High-Level Synthesis Tutorial)
[목차][이전][다음]